第四讲:智能体的记忆与技能
精读CMU智能体课程第四讲,梳理智能体记忆与技能:三种经验类型、Agent Skills标准与渐进式披露、MemGPT与Mem0等记忆系统,以及文本与代码技能的归纳和生命周期管理。
这是我精读卡耐基梅隆大学(CMU)公开课「AI Agents(11-768)」系列的第四篇。在正式解读之前,让我们先温故知新,快速回顾前三讲已经探讨过的主要内容:
第一讲:AI Agents 概述和工作原理—— 讲清一件事:Agent = 一个跑在循环里的模型(a model in a loop)。
第二讲:语言模型智能体的工具调用 ——工具,是让模型从「只会说」跨到「能做」的接口;以及代码如何作为「元工具」。
第三讲:智能体的长上下文建模 —— 当历史在单个任务内越堆越长时,系统怎么才能既用得动、又供得起。
第三讲探讨的是「一个任务之内」的事。第四讲将把镜头拉得更远:跨任务。(对整门课还不熟悉的朋友,也可以先看看这篇课程系列简介。)
第四讲由 Daniel Fried 主讲(Graham Neubig 也参与了大量互动),主题是 Memory and Skills for Agents(智能体的记忆与技能)。一句话概括这一讲的世界观:
别让 Agent 每次都从零开始。把过去做过的、值得复用的经验,沉淀成可以被检索、被检查、被修改、被维护的外部产物 —— 这就是记忆与技能。
即使今天我们有了上百万 token 的上下文窗口,一旦你连续让 Agent 干很多任务,还是会超出窗口。你会希望它记住过去任务里学到的东西,在未来任务上做得更好。我把整场录播和讲义都啃了一遍,下面带你把干货过一遍。
一、动机:大量结构会在任务间重复出现
先看一个购物网站的例子。你给 Agent 两个任务:
任务 #1:把索尼耳机加入我的心愿单
任务 #2:查一下无线键盘的价格区间
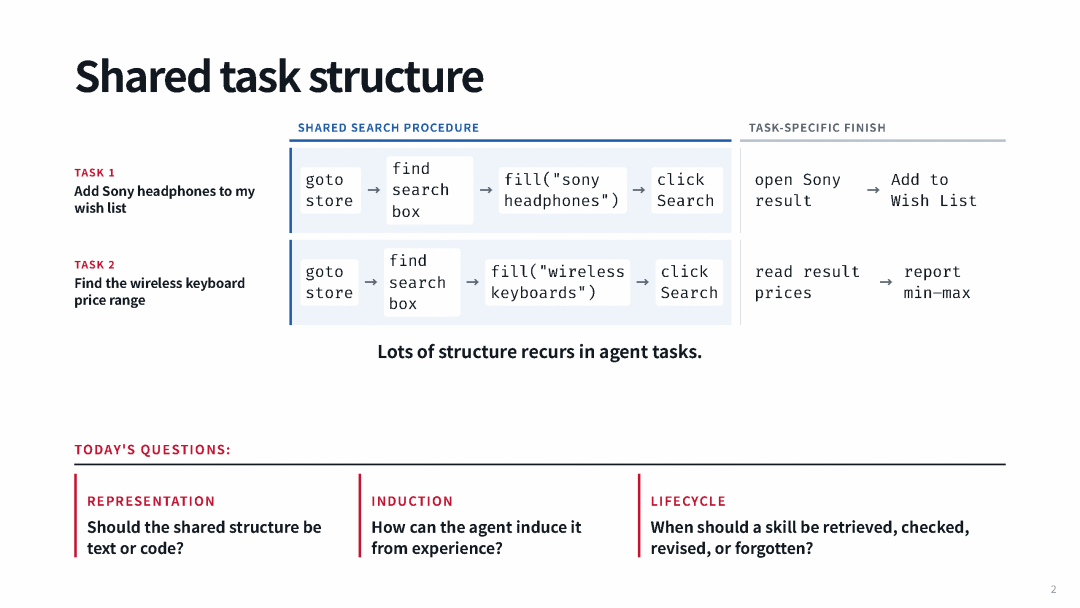
你会发现:两个任务的前半段几乎一模一样 —— 进商店、找搜索框、填词、点搜索,只有收尾不同。如果 Agent 第一次费了半天劲才搞懂怎么搜索,那它理应能在未来复用这份知识。这一讲就是关于:如何表示这段共享结构、如何从经验中归纳它、以及如何管理它的生命周期。
更新一个 Agent,有三种地方可以「写入」
Fried 给了一张贯穿全课的对照表 —— 你想让 Agent 变得更好,本质上有三个地方可以下手:
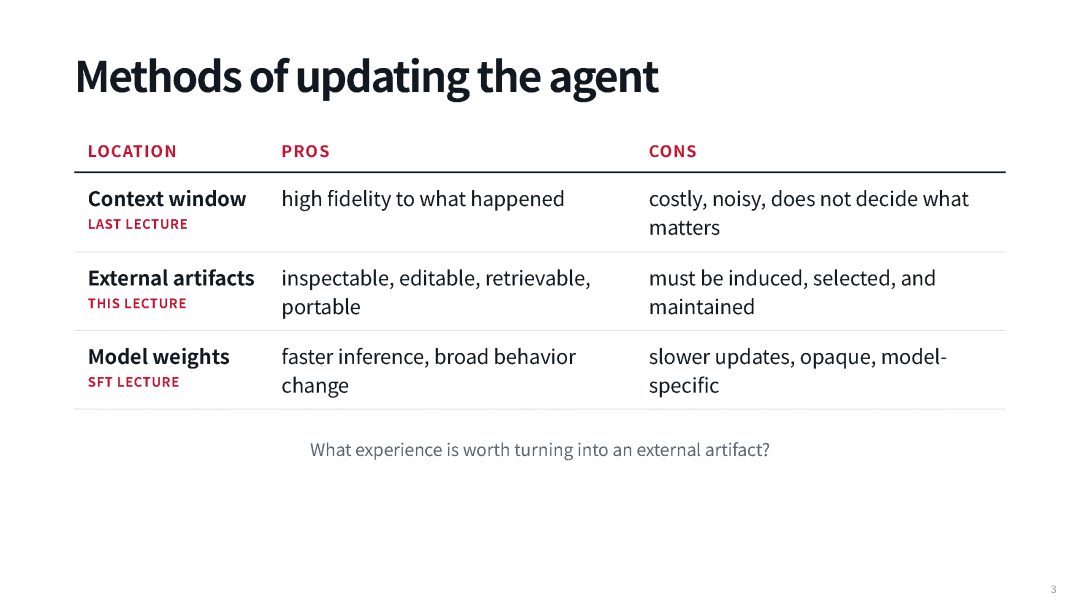
位置
优点
缺点
上下文窗口
(上一讲)
对发生过的事高保真
昂贵、嘈杂,且不替你决定什么重要
外部产物
(本讲)
可检查、可编辑、可检索、可移植
必须被归纳、筛选、维护
模型权重
(后续 SFT 讲)
推理更快、行为改变广泛
更新慢、不透明、绑定特定模型
外部产物有两个突出优点:可跨模型移植(一段「怎么在这个网站搜索商品」的描述,任何模型都能用;而改权重只对那一个模型有效),以及可被人检查(你能读它、改它,人和系统之间有了一个可解释的接口)。核心问题于是变成:什么样的经验,值得被固化成一个外部产物?
三种经验类型:Episode / Fact / Skill
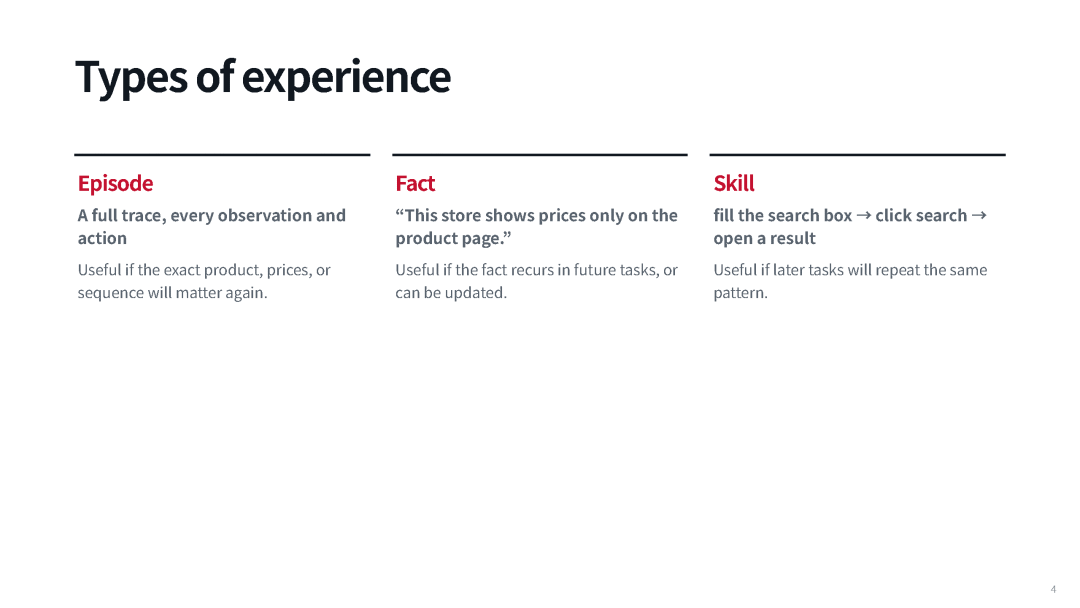
Episode(轨迹/情节):一次完整的记录 —— 所有观察、所有动作。保真度最高,但也最费 token。就像监督学习里我们不想记住每个细节,而想抽象出真正重要的部分来泛化。
Fact(事实):关于环境或用户的知识。早期记忆系统大多聚焦于此——你告诉助手你多大、住哪儿,它存下来,未来对话就能用。如果你用过 ChatGPT 或 Anthropic 的记忆功能,它们做的基本就是这件事:进设置能看到模型从你过去交互中提炼的一段文本。
Skill(技能):更专属于 Agent —— 如何完成任务的一部分,且抽象掉了具体细节。比如「怎么在某网站搜商品」而不记住「搜的是哪个具体商品」。技能只有在同一个子任务会被做不止一次时才有价值。
Memory 与 Skill 的关系
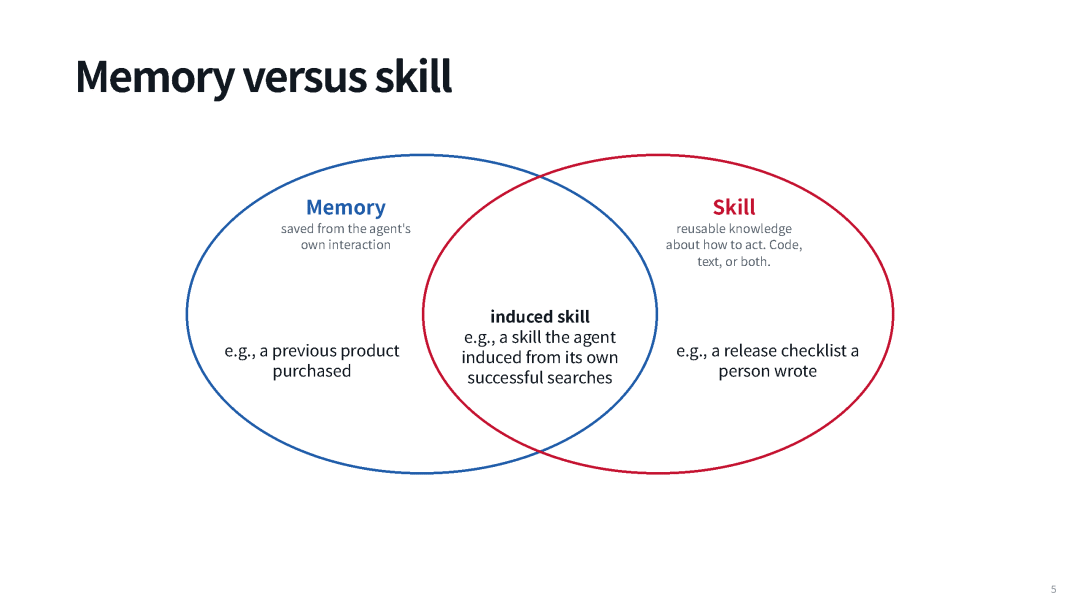
记忆是从交互中保存的东西;技能是关于如何行动的可复用知识。技能既可以由人编写(编码个人偏好或组织政策,比如「我们公司这样写和测代码」),也可以由 Agent 从过去经验中归纳。二者互补:
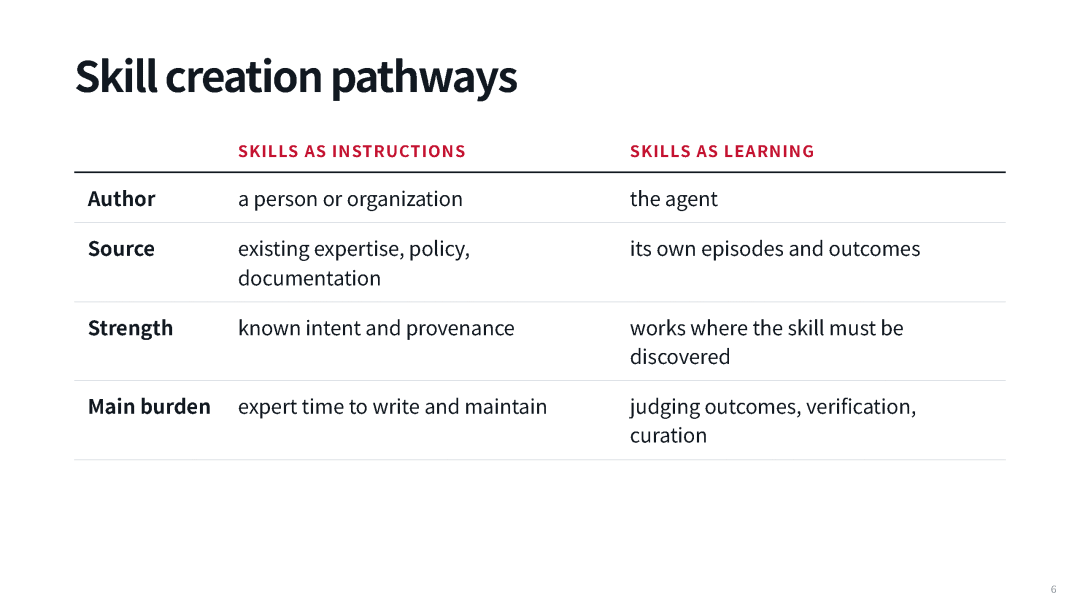
技能即指令:人写的,意图明确、来源可溯、质量可控,但要花时间写和维护。
技能即学习:Agent 自己归纳的,可自动化(归纳 → 复用 → 看指标是否变好的循环),但可能有噪声、甚至带来意外后果。
Fried 还提了一个课堂上很有意思的观察:让模型替另一个 Agent 写技能时,模型往往过度推断、写得太满,接手的模型会「照章办事」做了一堆你其实不想要的事;但如果你明确提示它「为另一个 Agent 写指令」,让它去模拟对方的心智,效果会好很多。
二、人工编写的技能:Agent Skills 标准
先讲人写的技能。一个典型场景:你每次都给编程 Agent 敲同样的指令 —— 用某个格式化工具、某套 lint 规则、给所有公开 API 加类型提示、用某种风格的 docstring、给新函数都写测试……
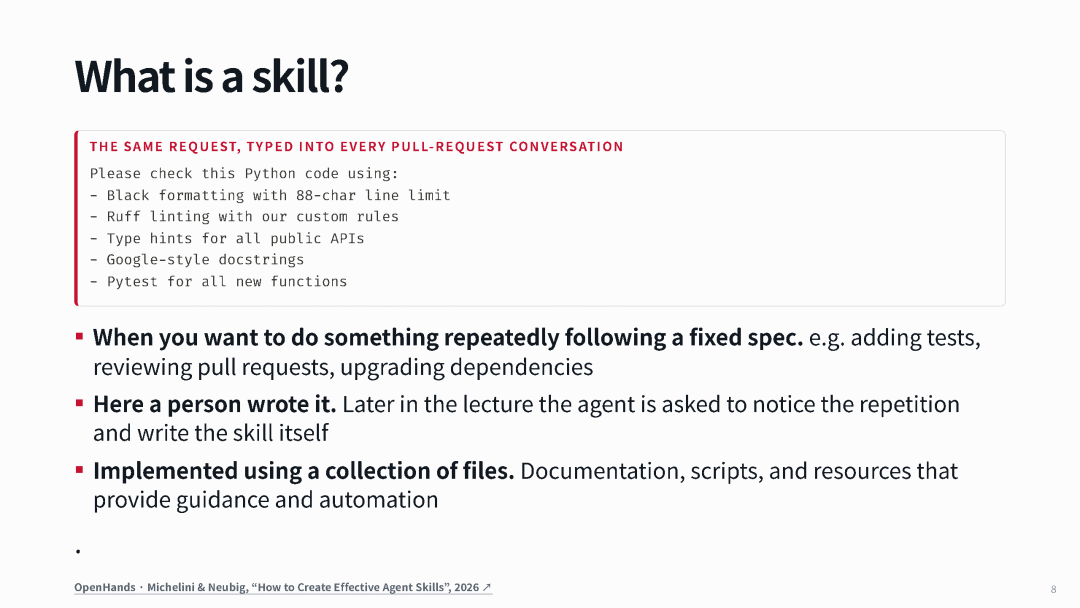
与其每次手敲,不如把这份规范存成文件,让 Agent 当指令来读。当你想按一份固定规范反复做某事时,就该伸手去拿一个技能。当前的事实标准叫 Agent Skills,它就是一组 Agent 能读的文件:
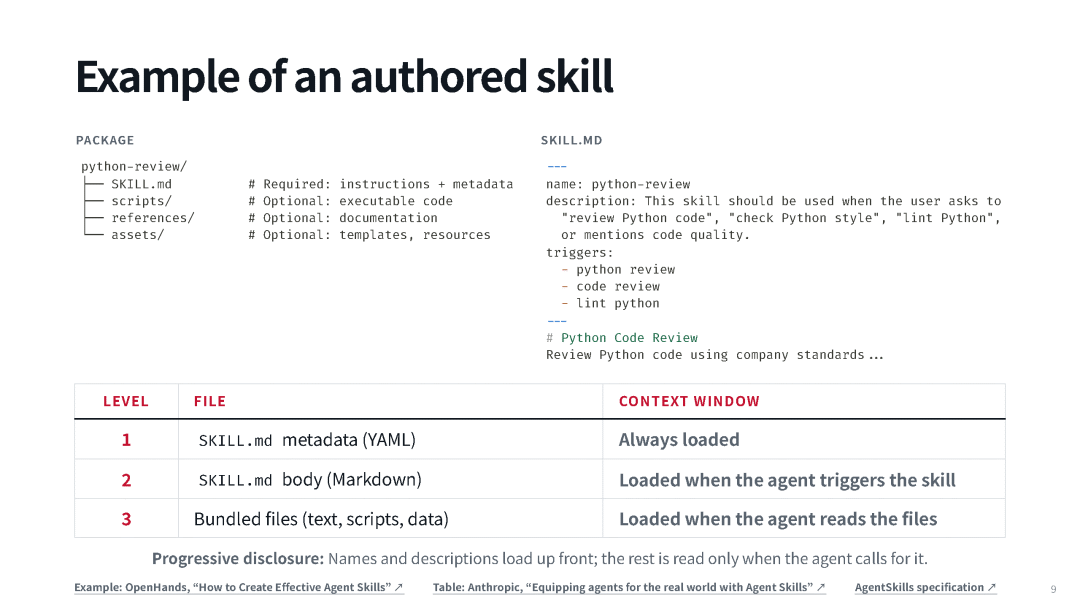
一个技能包的标准结构:
python-review/├── SKILL.md # 必需:YAML 元数据 + Markdown 正文├── scripts/ # 可选:可执行代码(如跑 linter 的脚本)├── references/ # 可选:补充文档,按需加载└── assets/ # 可选:模板、资源
SKILL.md 开头是 YAML 元数据(name + 一句 description,告诉模型何时该用这个技能),正文则详细写清怎么用。
渐进式披露(Progressive Disclosure):别撑爆上下文
技能信息可能很多,我们不想把所有可能用到的技能全塞进上下文。解决办法是渐进式披露 —— 按需给模型看相关部分:
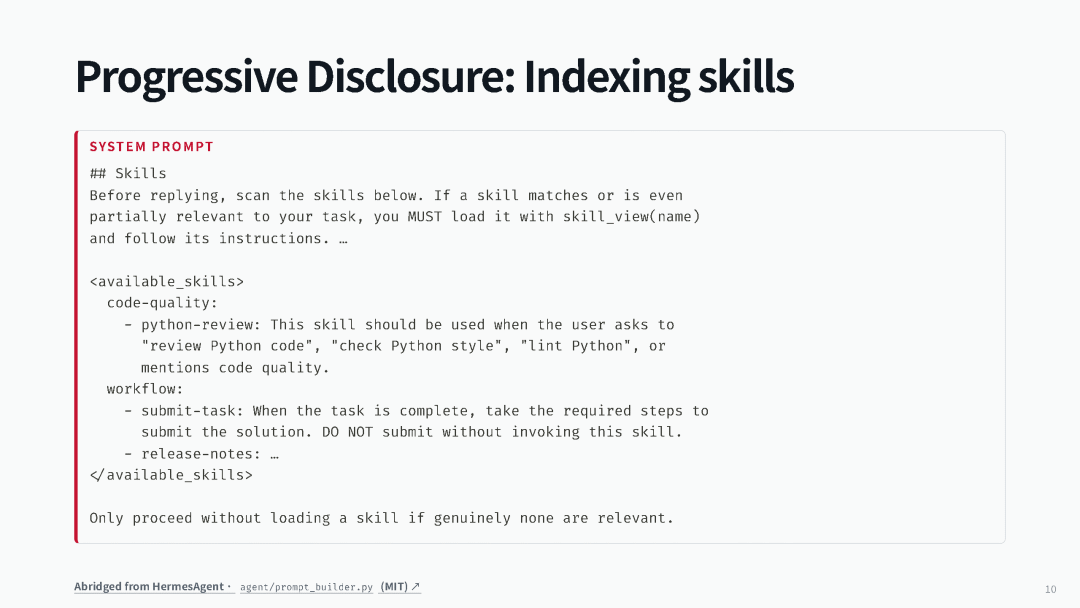
三个层级依次加载:
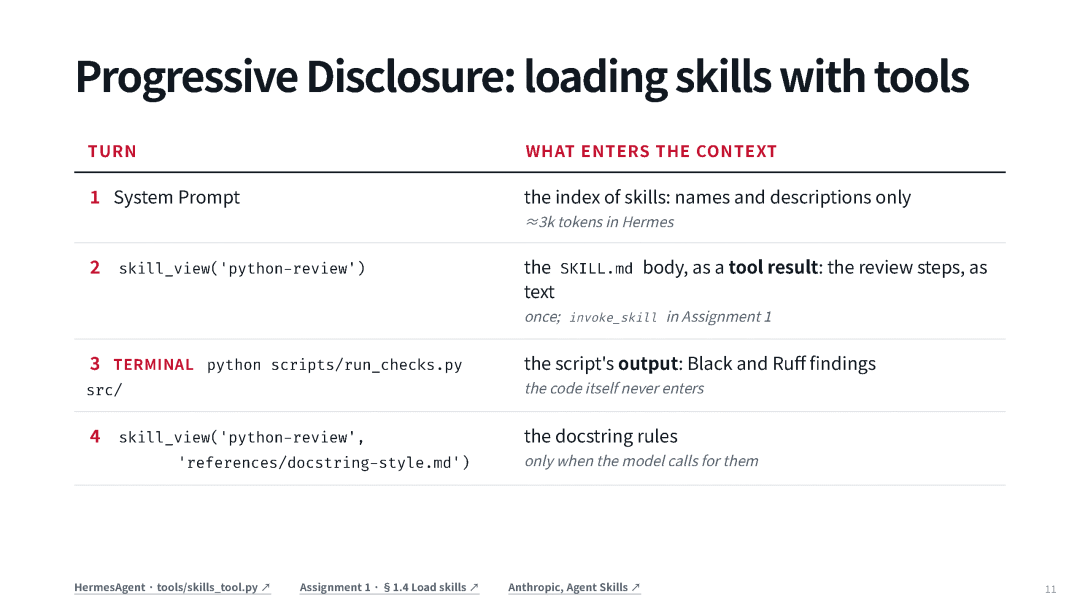
系统提示:只放技能索引(名字 + 描述),Hermes 里约 3000 token。
skill_view ('python-review'):模型判断相关后,才把 SKILL.md 正文作为工具结果读进来。
跑脚本 / 读引用文件:只把脚本输出(而非代码本身)读进上下文;docstring 规则等也是模型主动调用时才加载。
名字和描述在最前面就加载,其余的只在模型主动要的时候才读。
课堂互动里有两个好问题:技能太多会不会拖累性能? 会——即使元数据很短,加入无关技能也会拉长上下文、分散模型注意力,所以要控制技能数量、按需加载(Hermes 里技能描述总长约 3000 token)。**触发有多敏感?**触发是模型生成的工具调用,完全取决于模型能否根据上下文判断该不该触发 —— 所以我们需要评测。
SkillsBench:技能到底有没有用?
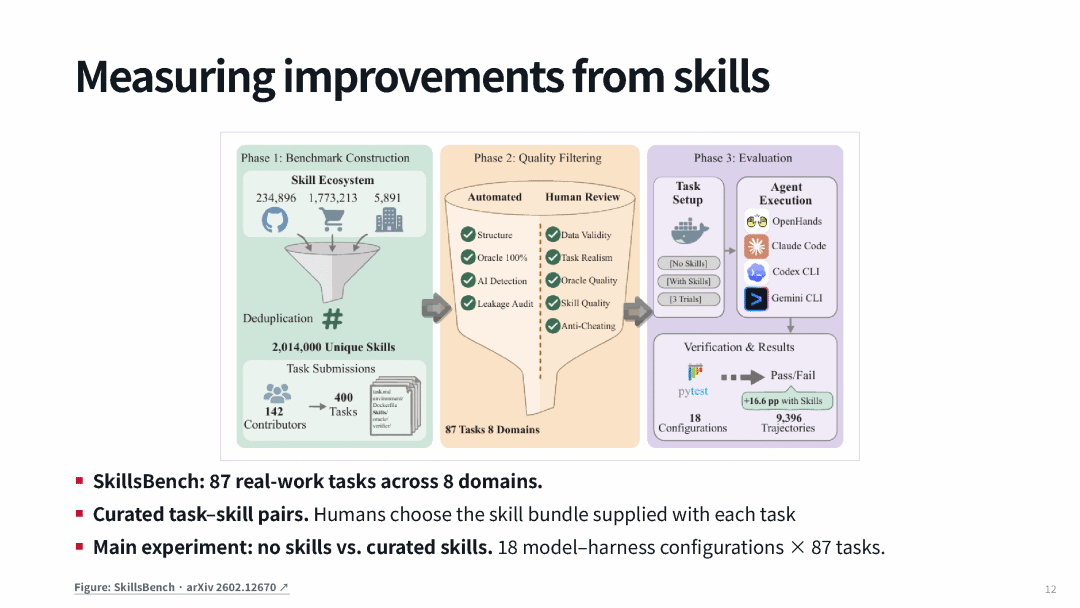
结论有喜有忧:
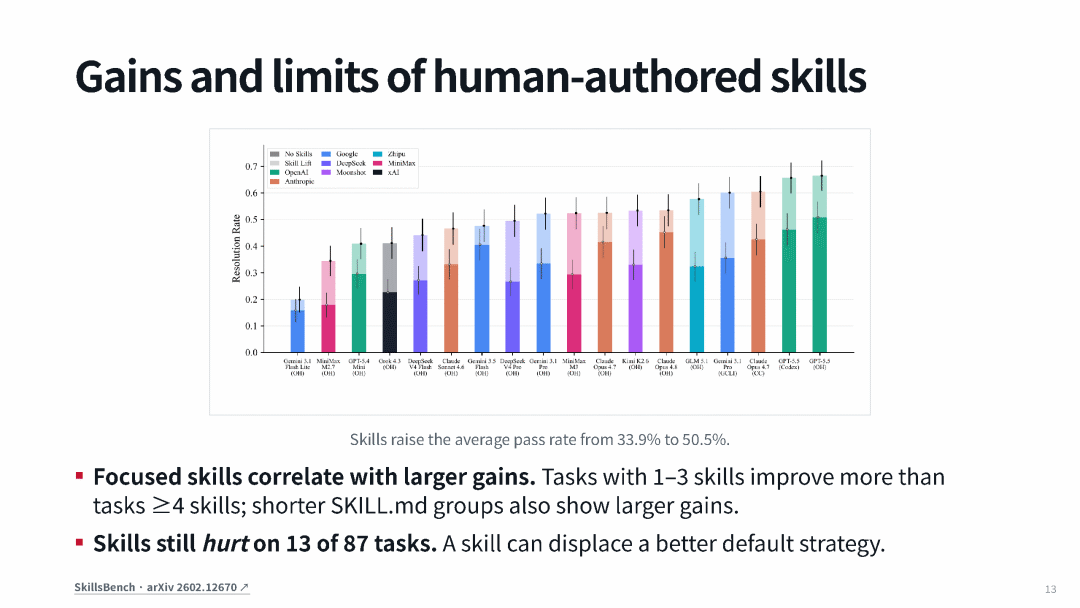
平均通过率从 33.9% 提升到 50.5%:技能确实有用。
越聚焦收益越大:用 1~3 个技能的任务,比用 ≥4 个的提升更多;SKILL.md 越短,收益越大。
但技能在 87 个任务里的 13 个上仍然有害:一个技能可能挤掉一个更好的默认策略。这就凸显了「检查你写的技能是否真的让输出变好」的重要性。
技能包从哪来,以及维护
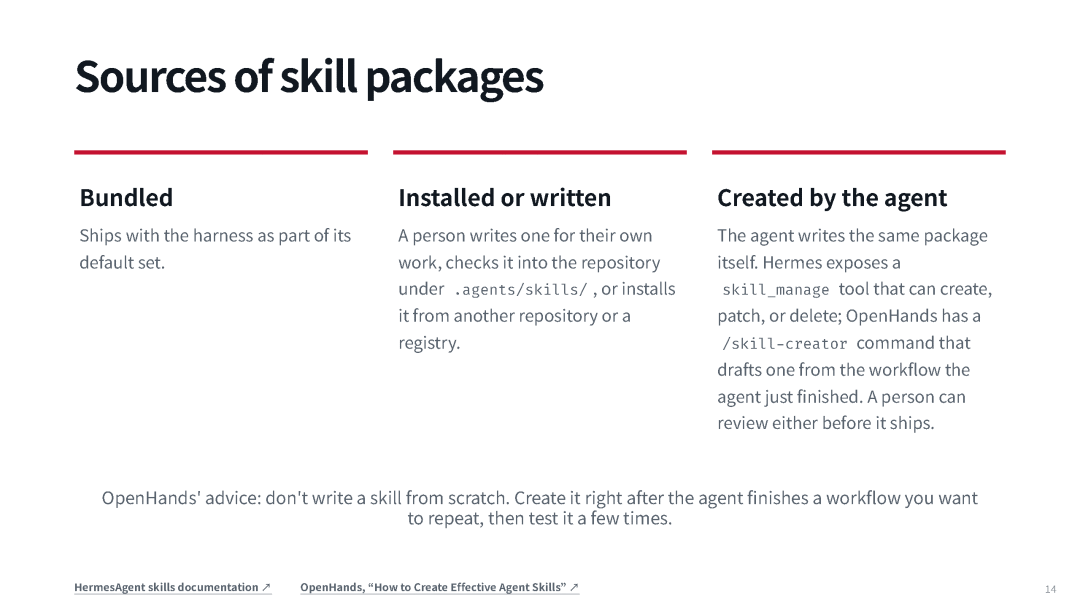
OpenHands 的关键建议:不要凭空从零写技能 —— 在 Agent刚做完一个你想重复的工作流之后立刻创建,然后测几次。SkillsBench 也发现:让模型仅凭任务描述先验地造技能,效果很差;因为做任务的过程本身会暴露出许多你事先不知道的「你想要的做法」。
维护一个技能同样重要,Fried 举了 OpenHands 维护代码评审技能的案例:
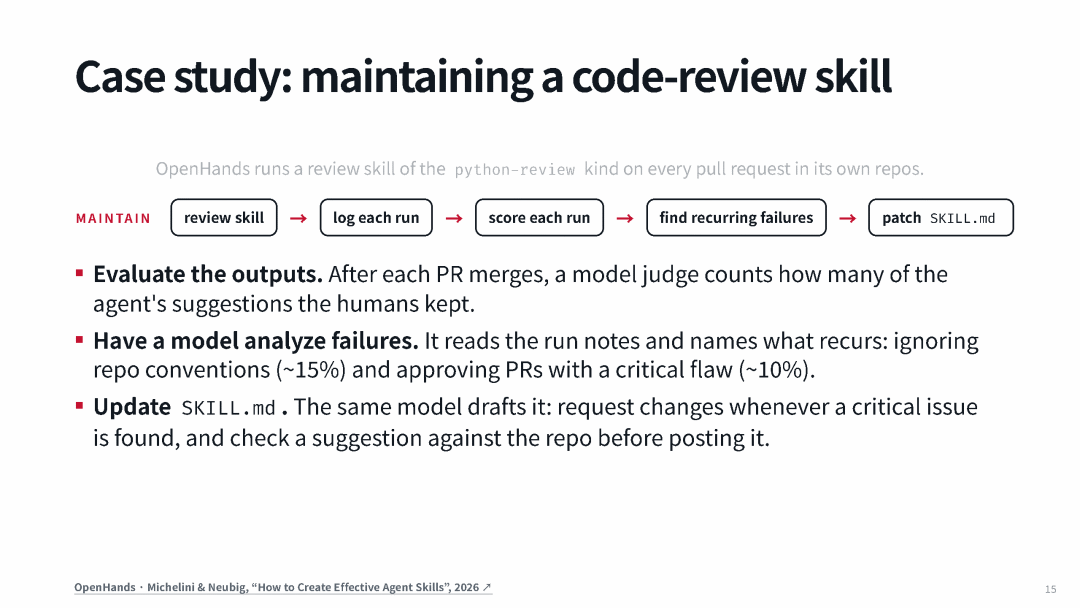
记录 → 打分 → 找反复失败 → 修补SKILL.md。
用模型裁判统计「Agent 的评审建议里有多少被人类真正采纳」,跑上成百上千个 PR,就能积累大量证据,再用推理模型总结出「忽视仓库约定(约 15%)」「放过严重缺陷(约 10%)」这类反复出现的问题,然后让模型提出对技能文件的更新。
三、记忆系统:事实、教训与轨迹
讲完人写的技能,转到让模型自动记住过去经验。这一段是后面「归纳技能」的基础。
MemGPT:把记忆搬到上下文窗口之外
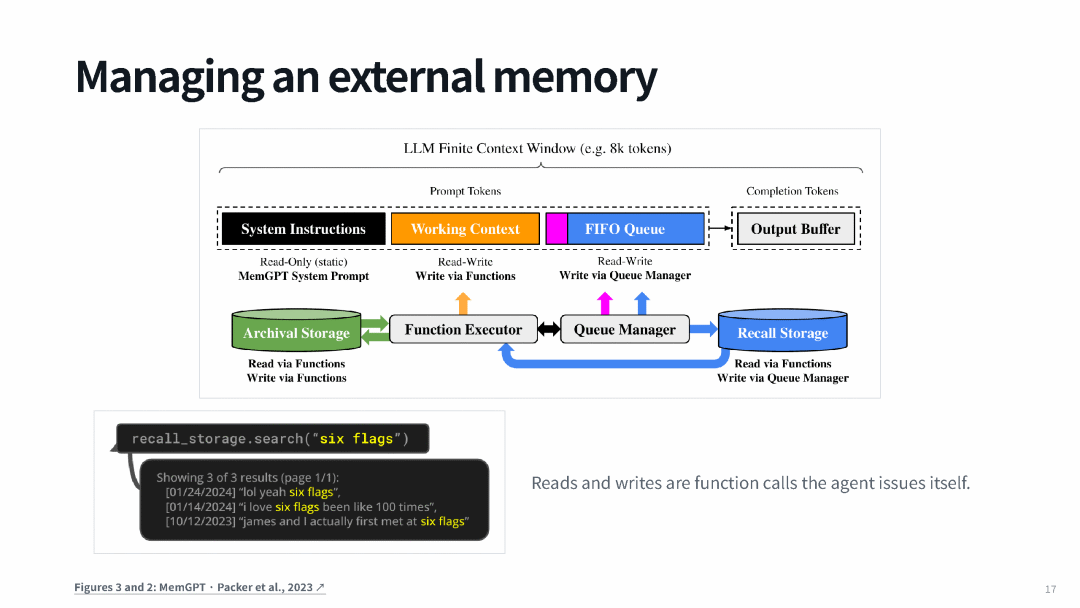
**MemGPT(2023)**是最早提出「在语言模型上下文窗口之外管理记忆」的论文之一,思路很有系统味:像内存层级一样 —— 上下文窗口是「快但小」的一层,外部存储是「大但慢」的一层。读写都由模型自己的工具调用控制。写这篇论文时上下文才 8000 token,这套方法尤其被需要;如今窗口大了,但要存的东西也大了,对 Agent 依然适用。
Mem0:记忆会冲突,需要更新与删除
光「添加」不够。比如你说「我在 X 公司工作」,后来换了工作,系统得能用最新信息。Mem0 引入了记忆更新机制:
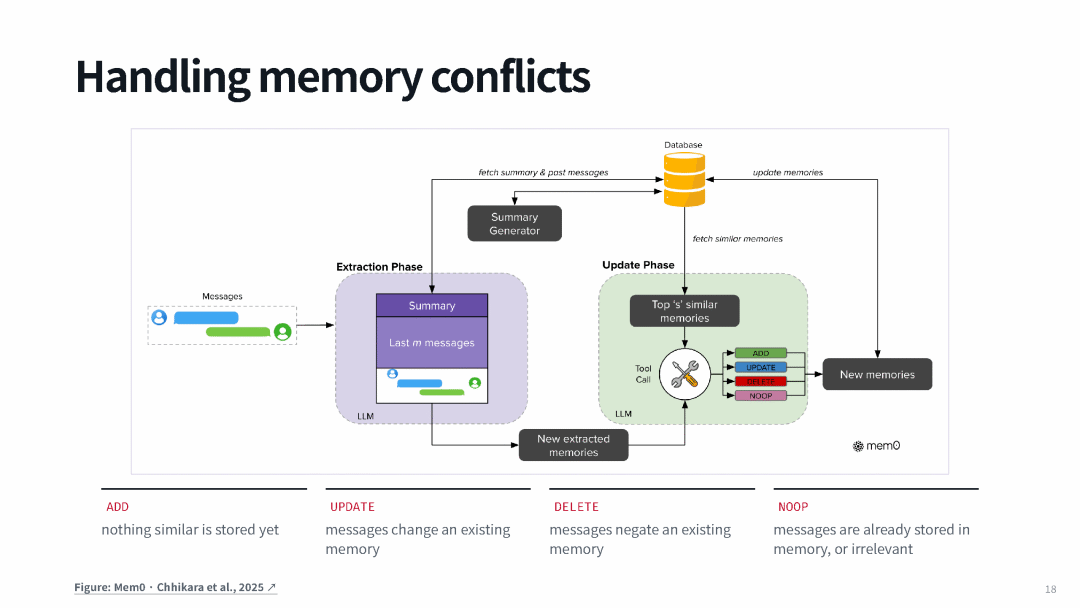
每来一条消息,用语言模型抽取候选事实,再用嵌入检索器从数据库里取出 top-K 相似记忆,然后判断做四种操作之一:ADD(还没存过)、UPDATE(改变了已有记忆)、DELETE(否定了已有记忆,比如「我被裁员了」就该删掉「我在 X 工作」)、NOOP(已存在或无关)。
这里 Fried 埋了个和上一讲的漂亮呼应 —— 他问学生「上下文管理那讲里,什么东西有类似的『更新/删除记忆』目标?」答案是 DeltaNet:线性注意力只能往记忆里「追加」值,而 Delta 规则能检索出某个 query 对应的存储值并修改它。这一讲的 Mem0,正是那件事的文本版类比。
Reflexion:从反馈中学习
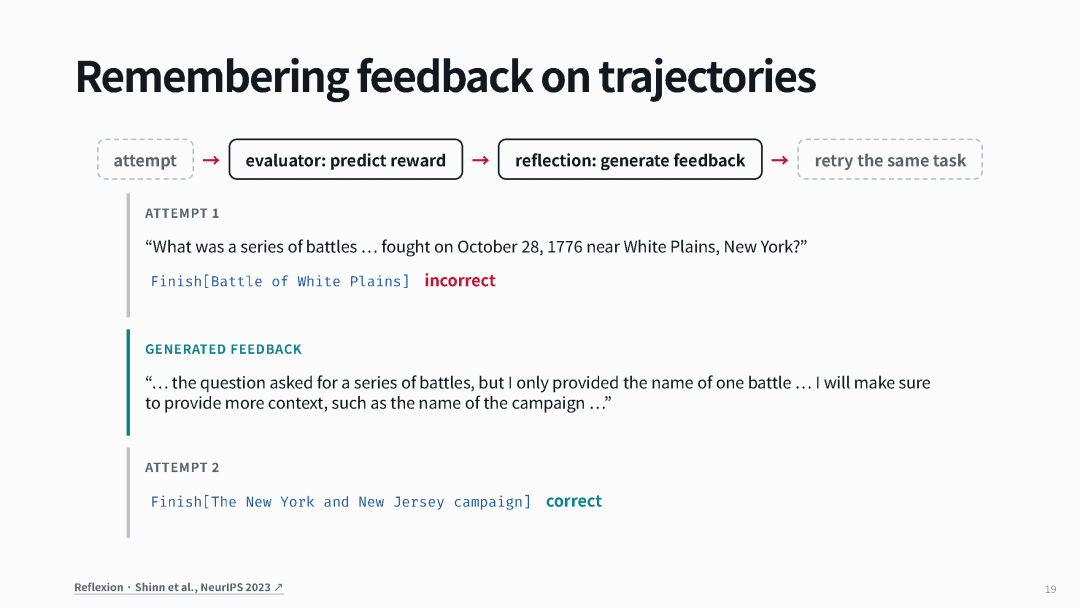
Reflexion简单却有效:给 Agent 多次尝试同一任务的机会,第一次失败后,用语言模型生成一段自然语言反馈(「你只答了一场战役,而问题问的是一系列」),第二次尝试时把这段反馈作为条件 —— 往往就答对了。这套还能推广到跨任务:只要反馈足够通用,就能帮到相似的任务。
相似轨迹条件:给 Agent 的 RAG
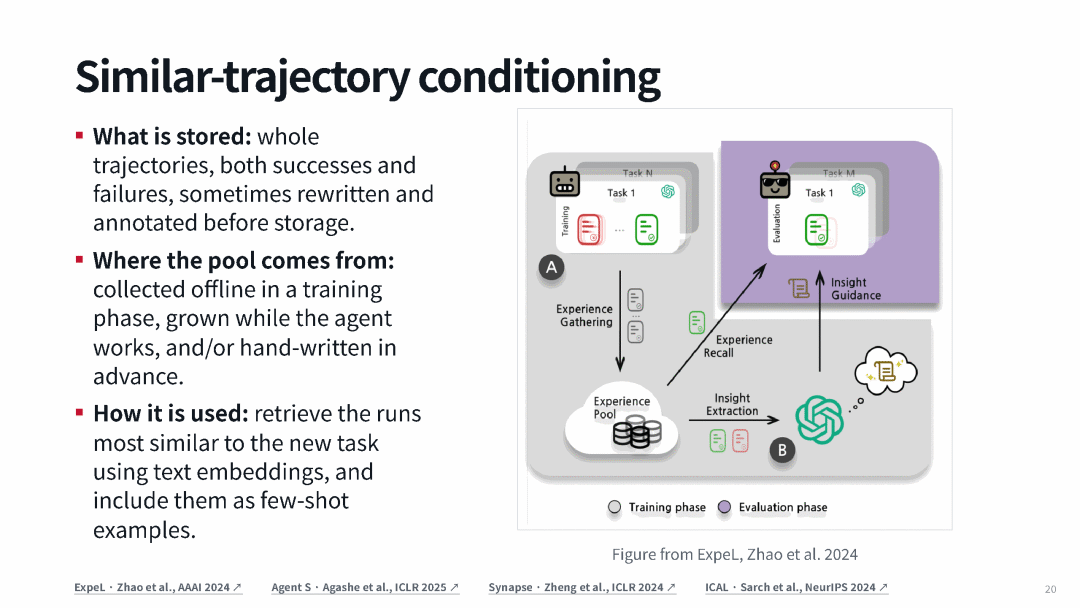
最后一种基础手段:记住整条轨迹,用来塑造未来的行为。有一堆论文这么做(ExpeL、Agent S、Synapse、ICAL)。核心都是:攒一批任务(人工示范或 Agent 自己跑出来的),可能再生成一些反馈文本;新任务来时,用嵌入检索出最相关的历史轨迹,作为少样本示例放进上下文。这本质上就是 Agent 版的 RAG。
四、归纳技能:文本 vs 代码
有了记忆的基础,就能讲归纳技能了。技能 = 任务里可跨任务复用的一段。
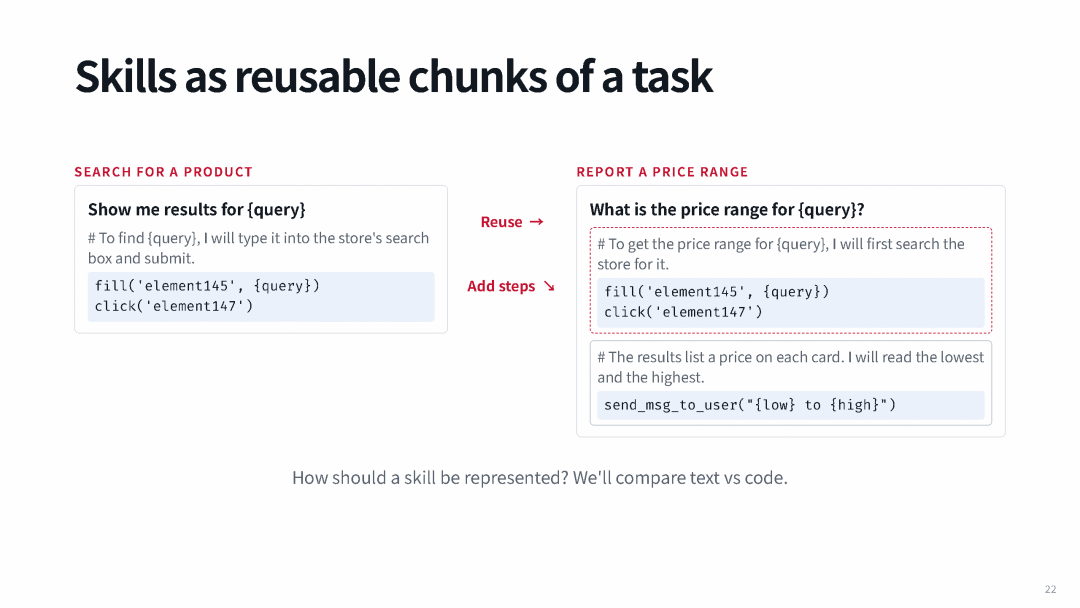
但直接存原始动作有个明显问题 —— 学生一下就答出来了:如果页面上的元素 ID 变了,技能就会失效;换到另一个搜索界面不同的网站,也会崩。所以「怎么表示技能」很关键。
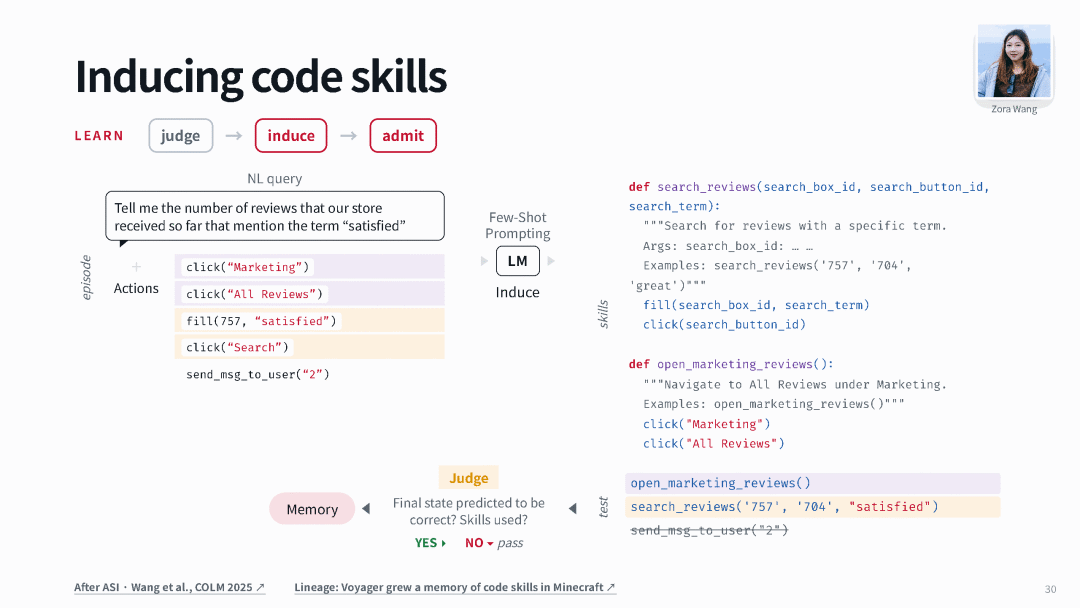
Fried 先致敬了几篇奠基工作:Voyager(在 Minecraft 里用代码函数控制 Agent,函数可互相调用,逐步组合出越来越复杂的行为)、DreamCoder(程序归纳:在已解程序里搜索可复用模式,抽象成函数,反复压缩),以及 LAPS / LILO(把大模型、Python 代码、自然语言描述结合起来)。
在线学习设置
评测在在线学习设置下进行:任务一个接一个到来,其中一些彼此相似;成功完成一个任务后,在下一个到来前更新记忆;我们关心的是累计成功率是否越来越高、能否解决越来越复杂的任务。
技能的生命周期
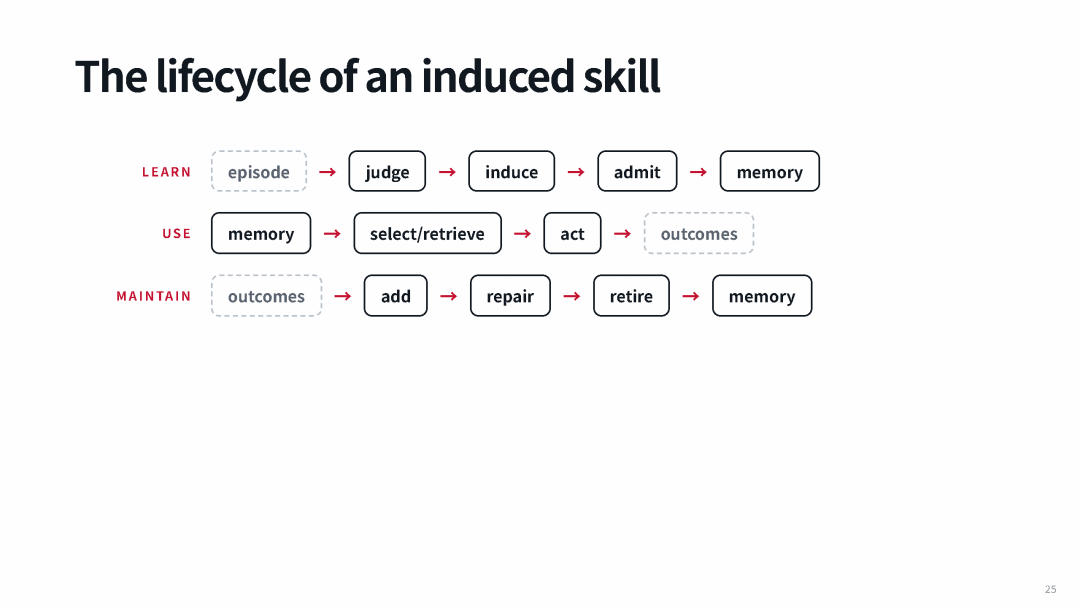
LEARN(学习):episode → 判断 → 归纳 → 准入 → 记忆
USE(使用):记忆 → 选择/检索 → 行动 → 结果
MAINTAIN(维护):结果 → 添加 → 修复 → 退役 → 记忆
AWM:Agent Workflow Memory
Fried 重点讲了自己团队(与 Neubig、Zora Wang 合作)的Agent Workflow Memory(AWM,ICLR 2025):
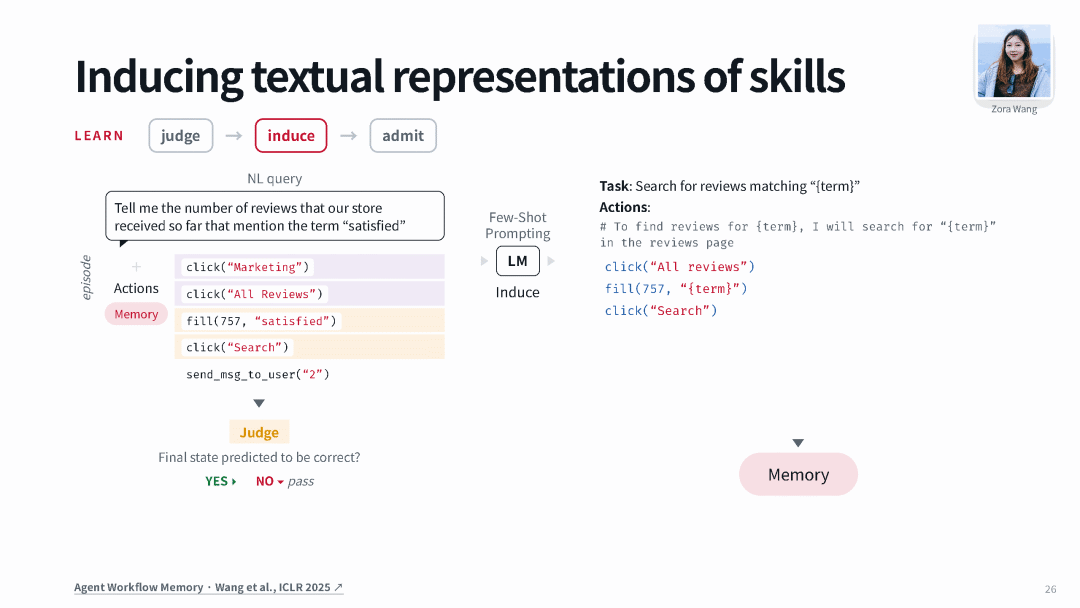
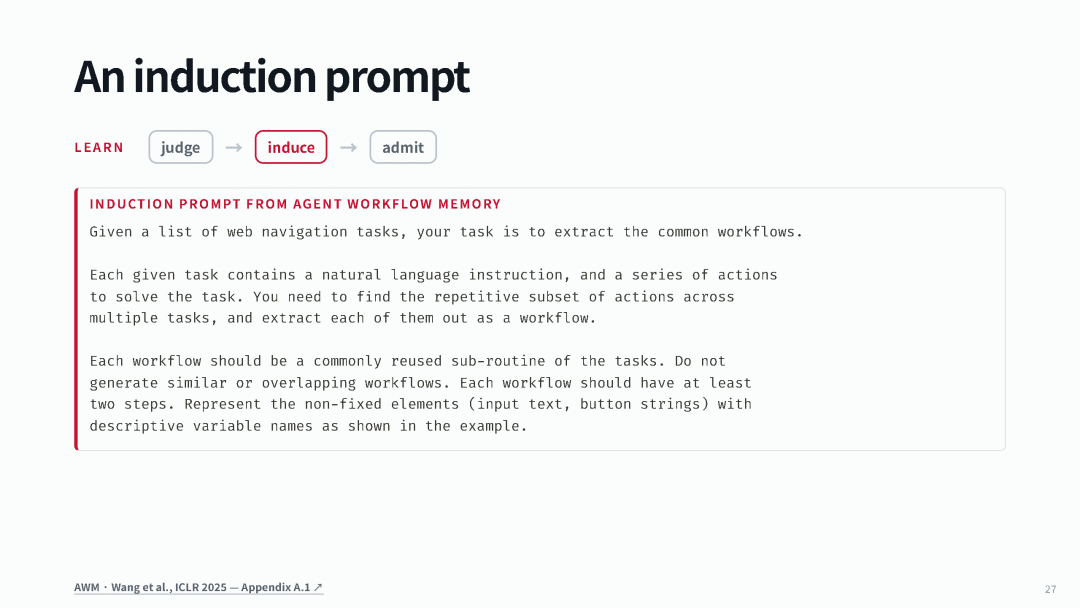
做法:让语言模型看一串工具调用,识别出未来可能复用的片段,输出成workflow(文本 + 动作的技能表示,带模板变量以便泛化)。关键一步是先用判断器(judge)预测这条轨迹是否正确 —— 只有判断为对的才准入记忆,免得错误经验把未来带偏。
效果:在地图工具的基准上,无记忆的基线收敛到约 10% 准确率,而加了子任务记忆的 AWM显著提升,还能完成基线根本做不了的复杂任务(如「找这个位置附近的酒店并显示步行路线」)。记忆在跨任务间复利式增长。
文本技能 vs 代码技能
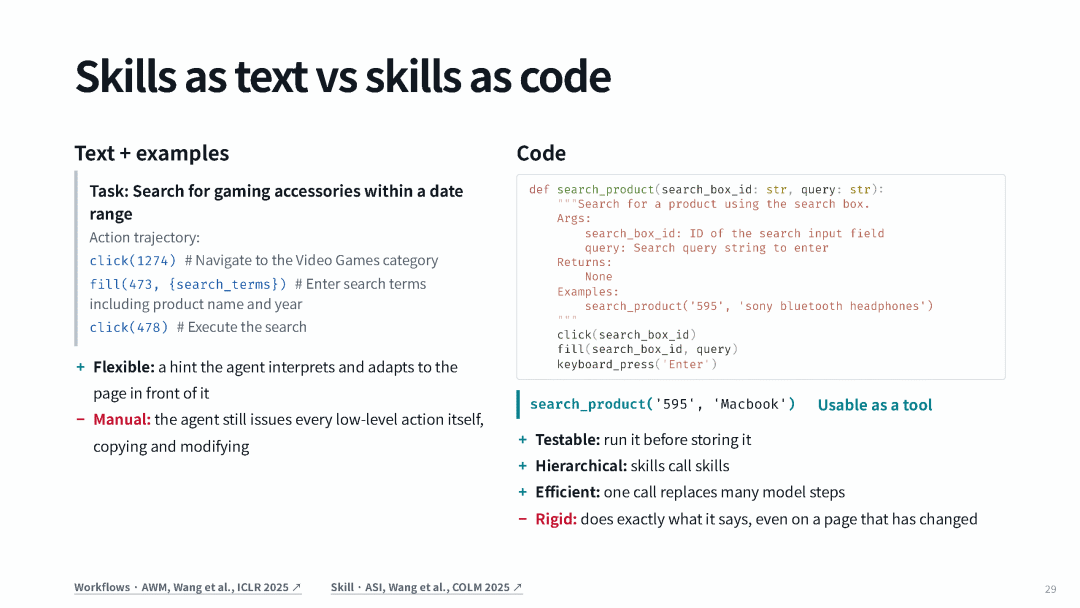
这是这一讲的核心对比:
文本技能(文本 + 示例动作):
✅灵活 —— 模型可解释、适配当前页面;页面元素变了,模型能选对的用。
❌手动 —— 模型仍要自己产出每一个底层动作。
代码技能(可执行函数):
✅可测试 —— 存进记忆前先跑一遍。
✅可分层 —— 技能调用技能。
✅高效 —— 一次函数调用替代多个模型步骤。
❌刚性 —— 它只做它写死的那几步,页面变了也照做不误。
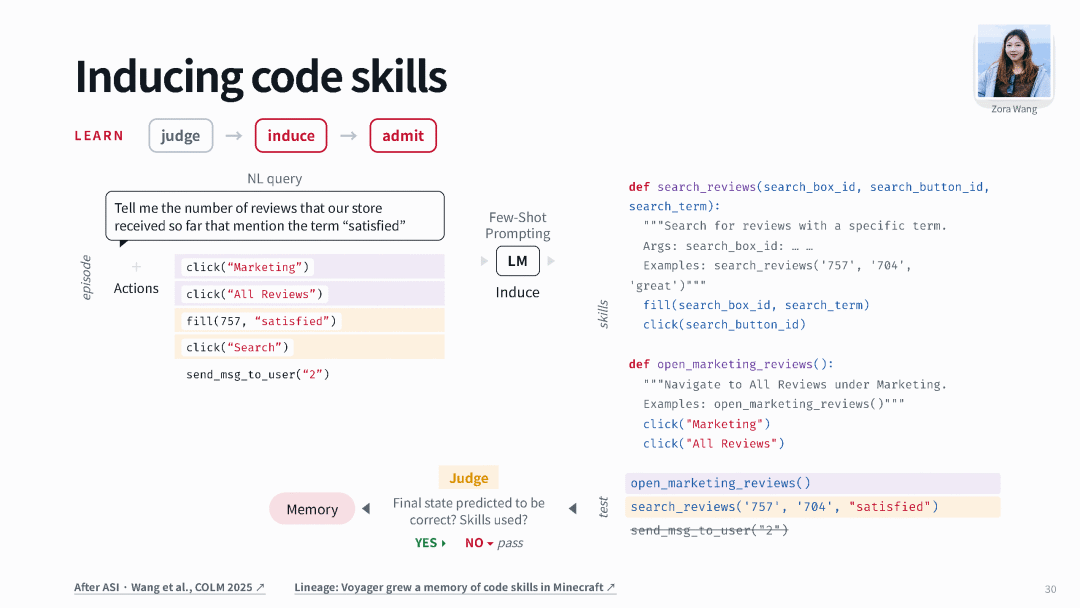
ASI(Agent Skill Induction,COLM 2025)归纳代码技能:让模型生成带 docstring 的函数,并重写原轨迹去调用它们。代码的妙处是能通过执行来测试 —— 不是判断原轨迹,而是执行归纳出的代码、再对最终结果应用判断器,这是更强的正确性信号;通过了就把这些代码技能当工具存入记忆。这等于在搭一个工具库。
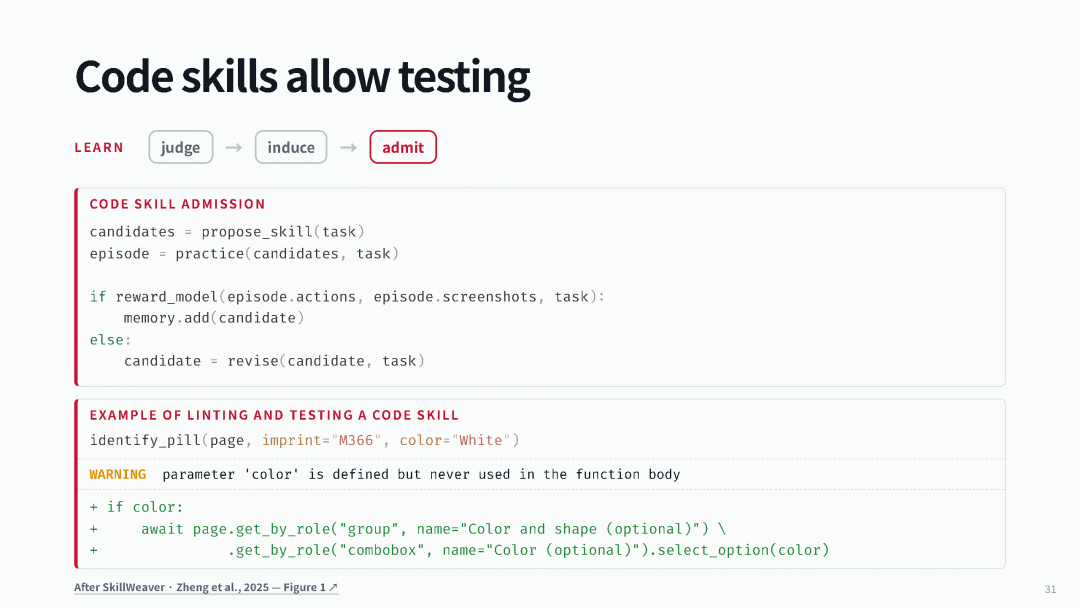
代码技能还能单独测试自己。SkillWeaver 就这么做:提出候选技能 → 练习执行 → 奖励模型判定成功则入库,否则修订。图里的真实例子:归纳出的 identify_pill 函数定义了 color 参数却没用上,代码 linter 直接报警,据此像 Reflexion 那样条件化地修出一个用上参数的新版本。
代码技能最直观的收益是大幅减少与环境的交互次数:
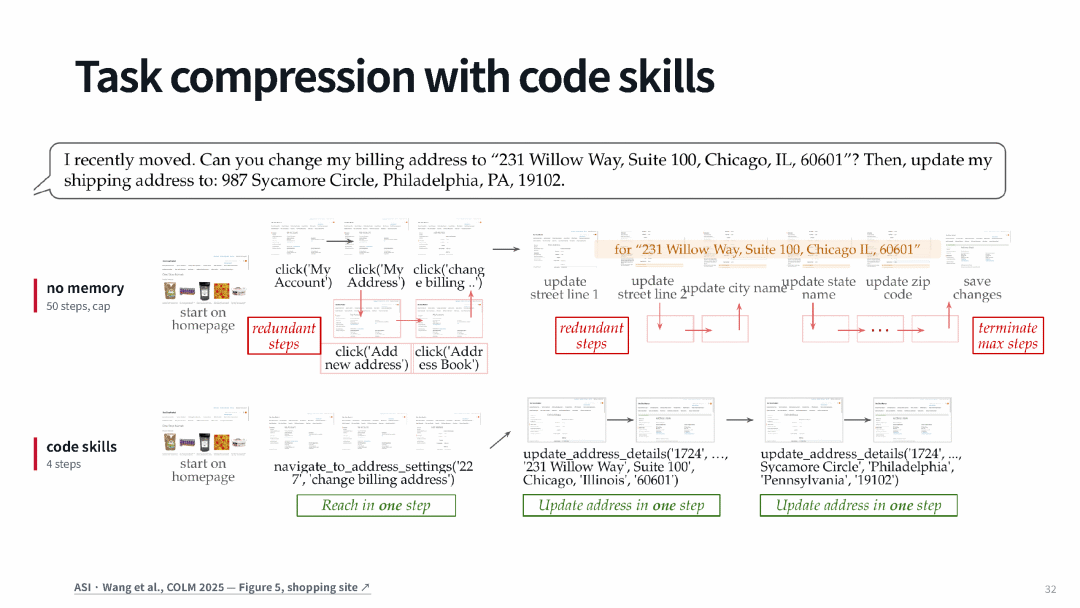
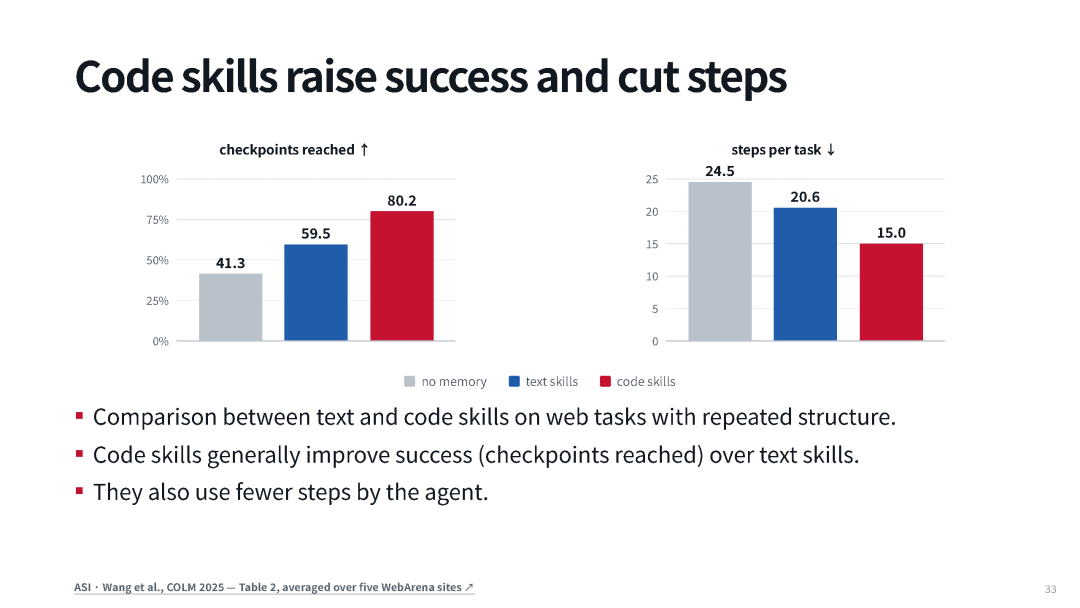
一个把地址更新任务从「几十个底层动作」压到三步(调两个归纳出的函数)的真实例子说明:由于 GUI Agent 的一大瓶颈是与页面交互的次数(每次都要重新观察页面、生成 chain-of-thought,吃大量 token),效率至关重要。控制实验也证实:相比无记忆,文本技能有帮助,代码技能帮助更大 —— 既提准确率,也大幅提效率。
但代码技能不够通用:PolySkill
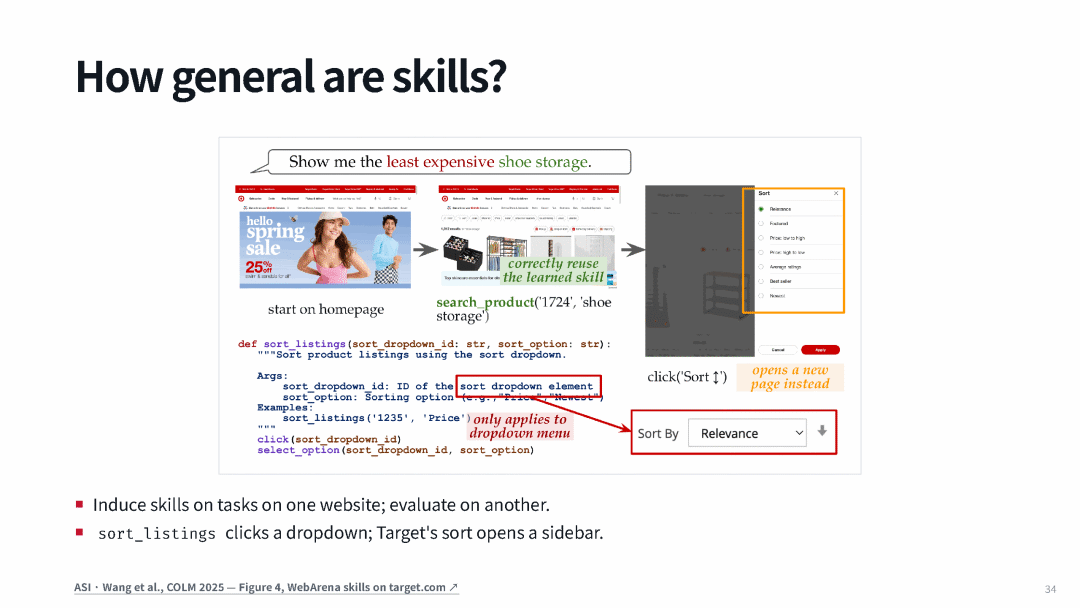
代码技能的软肋是不通用:在一个站点归纳的 sort_listings 假设排序是「下拉框」,到 Target 变成「侧边栏单选按钮」,就崩了。代码给出的解法是抽象类:
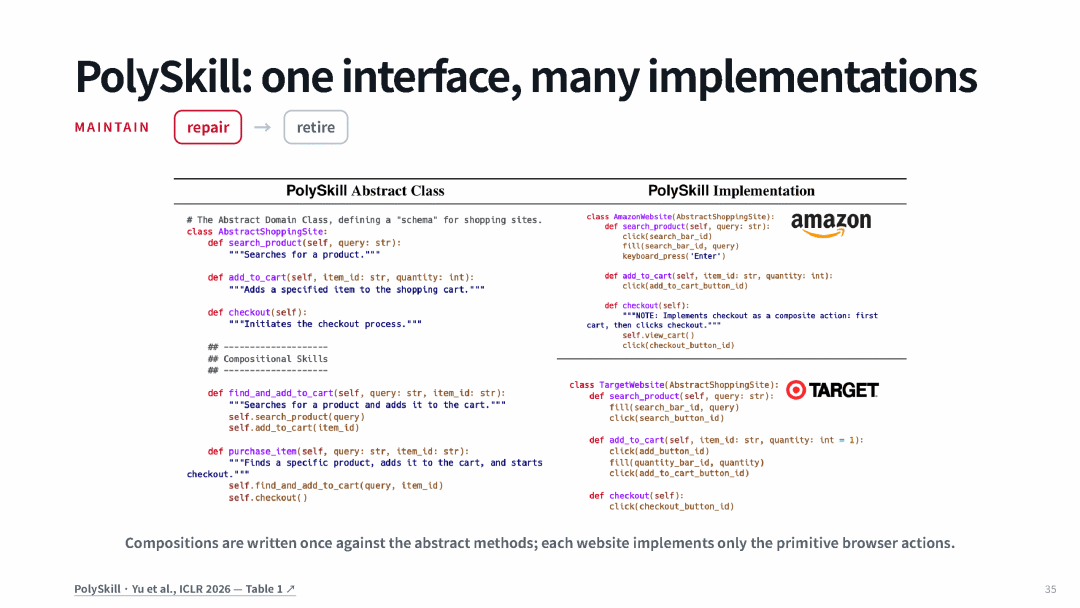
PolySkill 用抽象类 + 站点特定实现:组合逻辑针对抽象方法写一次,每个网站只实现底层原始动作。换站点时触发「这个具体实现不再适用」,改写一个新实例即可。这也让你能拥有大量特定技能、但只激活当前相关的一小部分 —— 不过是把软件工程的最佳实践搬到了 Agent 上。
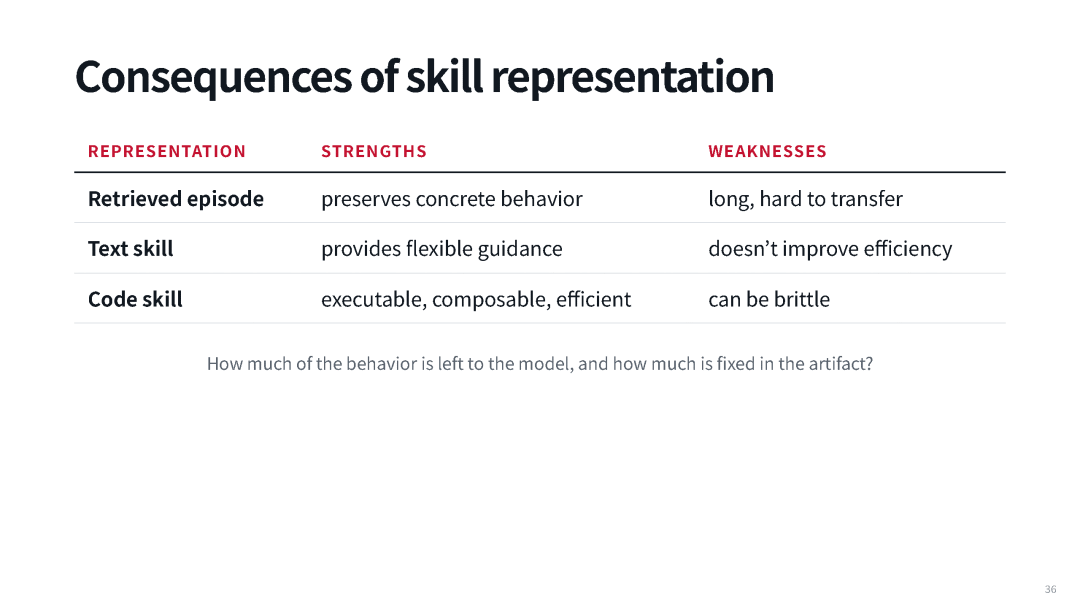
三种表示的权衡一目了然:检索 episode(保留具体行为,但冗长难迁移)、文本技能(灵活但不提效)、代码技能(可执行、可组合、高效,但可能脆弱)。
核心问题始终是:多少行为留给模型临场发挥,多少固定在产物里?
五、生命周期的三个真问题:失败、判断、检索
技能生命周期是个非常开放的研究话题。Fried 用最后一段快速过了几篇代表作。
从失败中学习:ReasoningBank
前面都是从成功中学习,但从失败中学习同样有用:
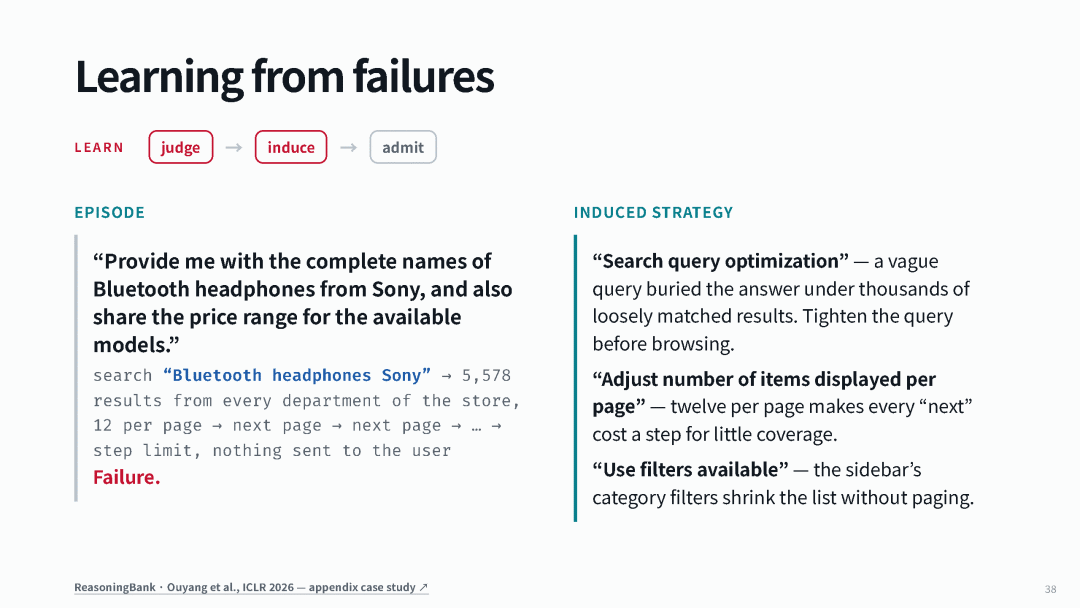
Google 的 ReasoningBank 例子:模型搜索时因查询太宽泛拿到 5578 条结果,一路翻页直到崩溃。但观察这条失败轨迹后,可以像 Reflexion 那样生成文本指导 ——「收紧查询」「调大每页条数」「用侧边栏筛选器」。它用的框架和 AWM/ASI 类似,但归纳的是适用于失败轨迹的文本策略。
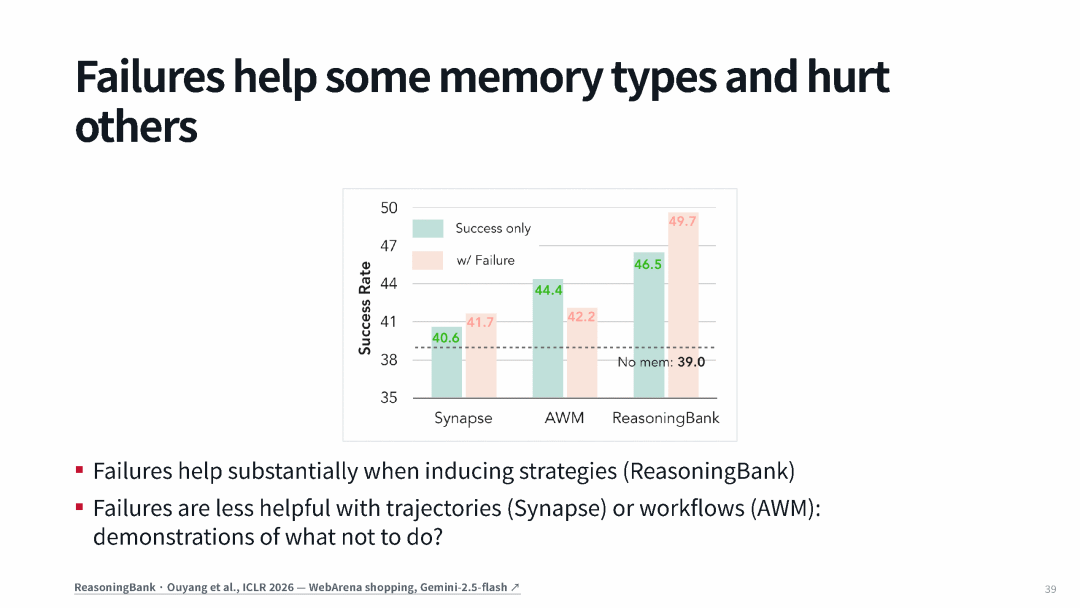
有意思的是:失败对「文本策略」帮助大,对「轨迹/工作流」帮助小。道理也讲得通 —— 你能用通用的方式描述「怎样避免失败」,却很难靠记住并条件化一条失败轨迹来学到东西。
判断器的精度有多重要?
要不要入库、归纳什么策略,大多靠模型裁判看最终状态判断成败。但裁判并不完美——它的精度有多要紧?
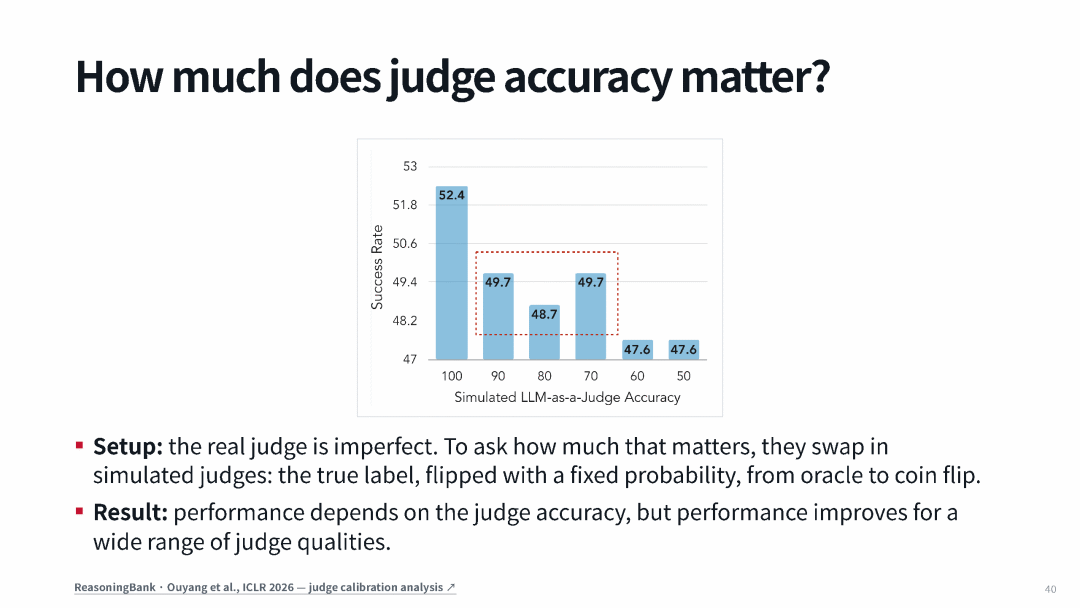
ReasoningBank 做了控制实验:从「完美裁判」逐步加噪到「抛硬币」。结果是性能确实随裁判精度下降,但在相当宽的一段精度区间里,用裁判来归纳记忆仍然有正收益 —— 存在一个「甜区」。
过度检索的代价
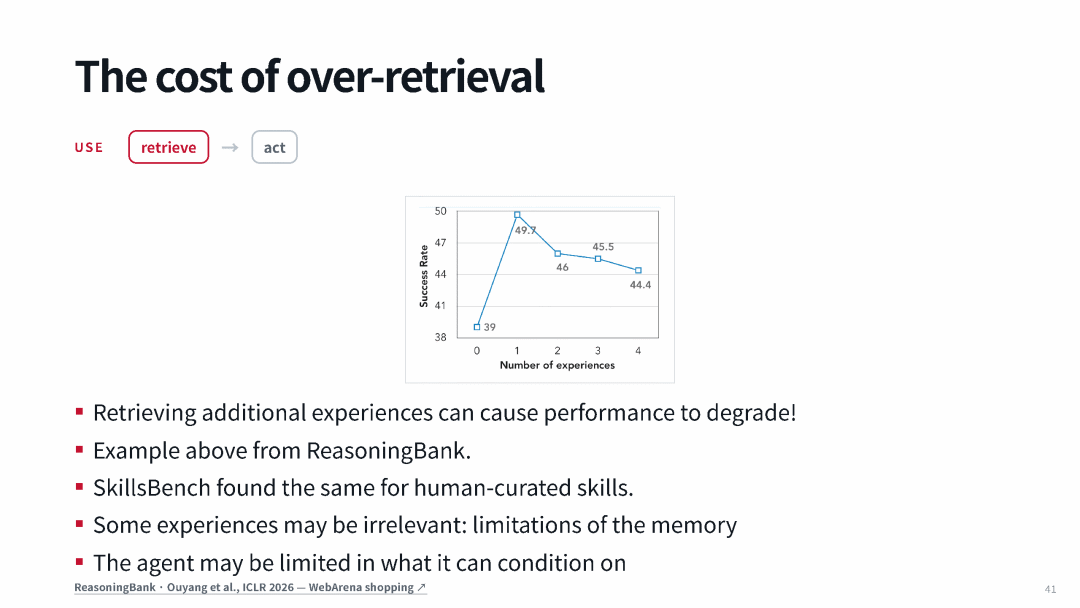
检索更多经验,反而可能让性能变差 :ReasoningBank 和 SkillsBench 都发现了这点。原因可能是:你还没跑够任务、记忆里根本没有相关的东西(方法的根本局限),也可能是模型本身被上下文里的无关内容带偏(这或许能靠训练模型「不被无关上下文分心」来改善)。
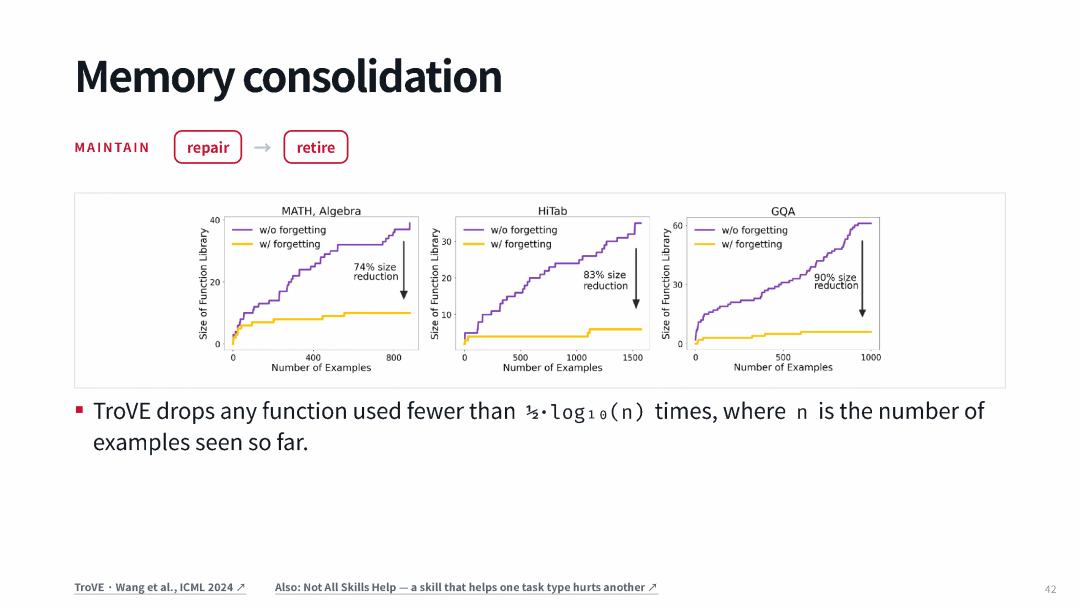
应对之一是主动缩减记忆。TroVE 用一个类似缓存的策略:看某条记忆过去被用的频率,不常用就丢掉(丢弃使用次数少于 ½·log₁₀(n) 的函数)。这既提效率(不必往上下文塞那么多),也可能提成功率(模型不再被无关项分心)。
能不能直接训练技能归纳器?
到这里,所有做法都有点临时(ad hoc)—— 我们只是提示语言模型去预测「什么可能有用」。一个很自然的问题:能不能直接训练模型来做这件事?
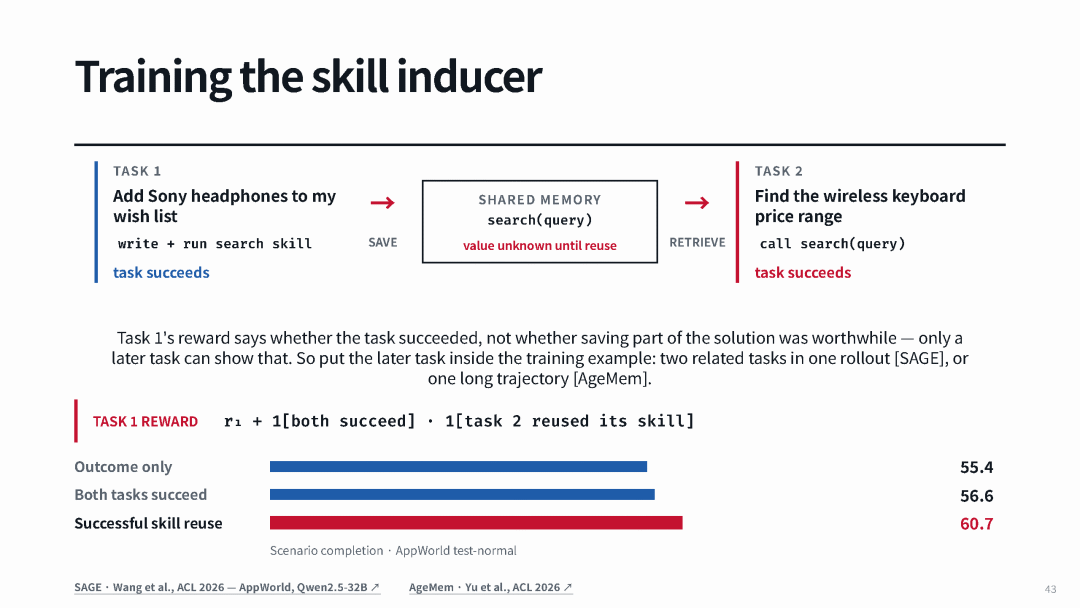
可以,而且刚刚开始被探索(SAGE、AgeMem,都是 2026 年 ACL 的新工作)。思路:在顺序到来的多个相似任务上做强化学习 —— 强化学习不在乎过程多复杂、可不可微。难点在于:任务 1 的奖励只告诉你任务成没成功,不告诉你「保存这段解法」值不值 —— 只有后续任务能证明。所以把后续任务放进同一个训练样本(一个 rollout 里放两个相关任务,或一条长轨迹),奖励设计成 r₁ + 1[两者都成功]·1[任务 2 复用了技能]。结果显示:加入「激励技能复用」的奖励项能进一步提升成功率(AppWorld 上从 55.4 → 60.7)。你也可以想象加入「最小化技能库规模」这类正则项,防止过拟合。
六、结语:什么值得被留下?
Fried 用一组张力收束整讲 —— 这也是留给我们思考的开放问题:
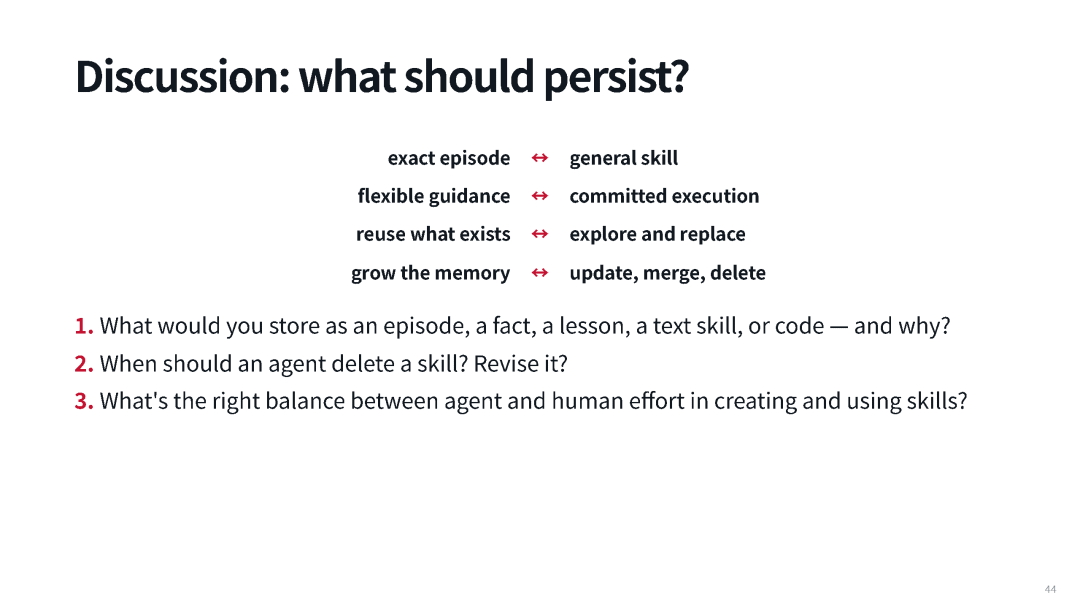
最后一张「记忆决策的归属」表,把「什么时候该靠 Agent、什么时候该靠人」讲得很清楚:
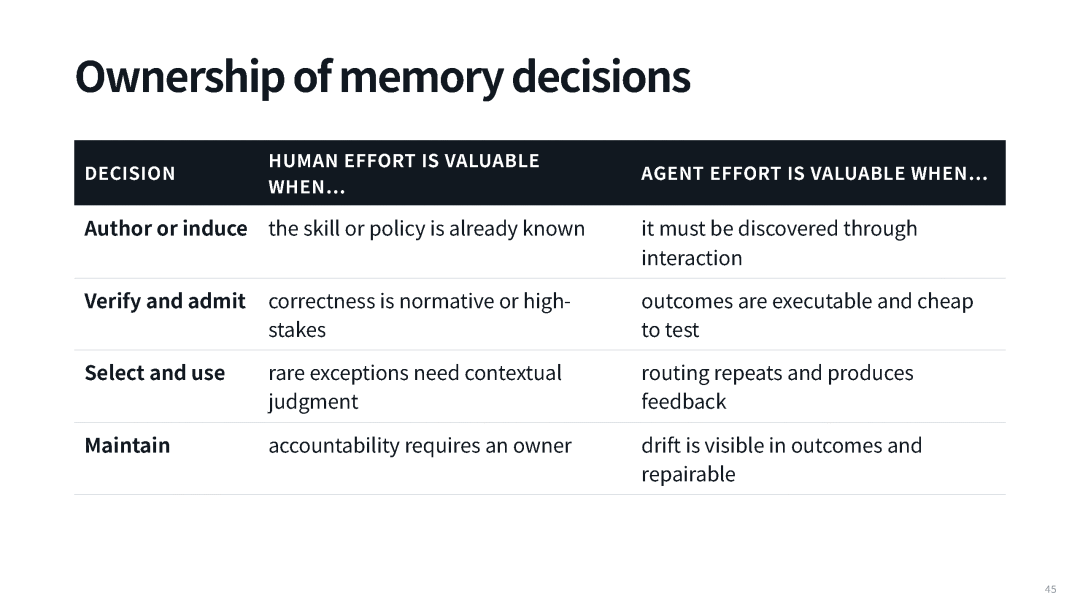
把这一讲拎成一条线:
为什么要记忆与技能:任务间大量结构重复,别让 Agent 每次从零开始。更新 Agent 有三处——上下文(上一讲)、外部产物(本讲)、权重(后续 SFT 讲)。
人工编写的技能:Agent Skills 标准(SKILL.md + 渐进式披露),聚焦、简短的技能收益最大,但用不好会挤掉更好的默认策略——所以要评测(SkillsBench:33.9%→50.5%)和维护。
记忆系统:MemGPT(外部存储)、Mem0(ADD/UPDATE/DELETE/NOOP)、Reflexion(从反馈学习)、相似轨迹条件(Agent 版 RAG)。
归纳技能:文本技能灵活但手动,代码技能高效可测可组合但脆弱(ASI/SkillWeaver),PolySkill 用抽象类解决通用性。
生命周期:从失败中学「文本策略」尤其有效(ReasoningBank);判断器有「甜区」;过度检索会伤性能,要主动缩减记忆(TroVE);甚至可以直接训练归纳器(SAGE/AgeMem)。
这一讲和前三讲连成了一条完整的线:第一讲:AI Agents 概述和工作原理 定位了「Agent = 模型 + Harness 的循环」,第二讲:语言模型智能体的工具调用探讨了循环里最关键的工具调用,第三讲:智能体的长上下文建模分析了解决单任务内上下文爆炸,这一讲则把视野拉到跨任务 —— 让 Agent 把经验沉淀下来、越用越强。下一讲,会转向 Planning(规划)。
如果你也想认真啃一啃「Agent 到底是怎么造出来、又怎么越用越聪明」,这门课的全部材料都免费公开:
课程主页:https://cmu-agents.com本讲视频:https://www.youtube.com/watch?v=6zigF2a-2Pw
愿我们都能在这个 AI 加速的时代,既跑得快,也扎得深。
朋友们,我们下一讲再见!
本文首发于 Haowen.AI 微信公众号。如果这篇分享对你有启发,欢迎点赞、收藏、转发给同样在学习路上的朋友。
雁评
真实、有观点的好评或吐槽,欢迎分享你的使用体验。