第二讲:语言模型智能体的工具调用
本文精读卡耐基梅隆大学AI Agents课程第二讲,系统讲解语言模型工具调用的定义、代码元工具、token机制、约束解码、REST与MCP及分层评测。
在上一篇里,我把卡耐基梅隆大学(CMU)公开课 “AI Agents (11-768)” 第一讲,拆开精读了一遍,讲清了一件事:Agent = 一个跑在循环里的模型(a model in a loop)。但第一讲留了一个关子:模型凭什么能“动手” ?它明明只会预测下一个 token。(对整门课还不熟悉的朋友,可以先看看这篇课程系列简介。)
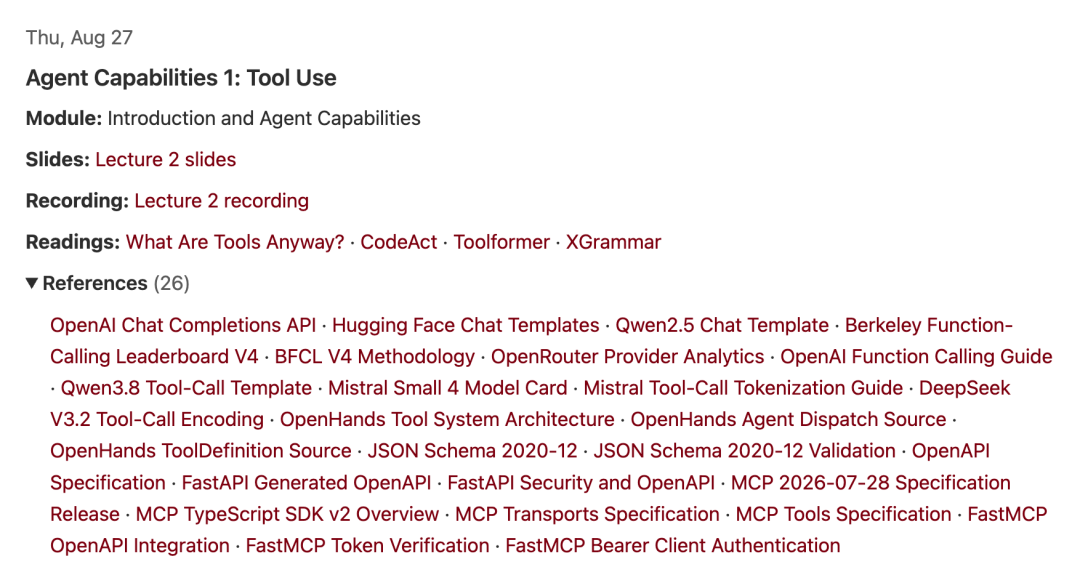
第二讲就来补这个关子。这一讲由 Graham Neubig 主讲,主题是 Tool Use(工具调用)— 他称之为 “把语言模型变成 Agent 最基础、最核心的一项能力” 。一句话概括这一讲的世界观:
工具,就是那个让语言模型从 “只会说” 跨到 “能做” 的接口。而 Agent 的一切能力,都建立在 “准确地调用工具” 这块地基上。
这一讲信息密度极高,从工具是什么,一路讲到怎么把工具喂给模型、怎么保证模型不乱吐、怎么用 REST / MCP 暴露工具、怎么并行调用、怎么评测。我把整场录播和讲义啃了一遍,下面带你把干货过一遍。
一、先说清楚:工具到底是什么,为什么需要它
Neubig 的定义很干脆:
工具,是语言模型用来调用一个外部计算机程序的接口(interface)。
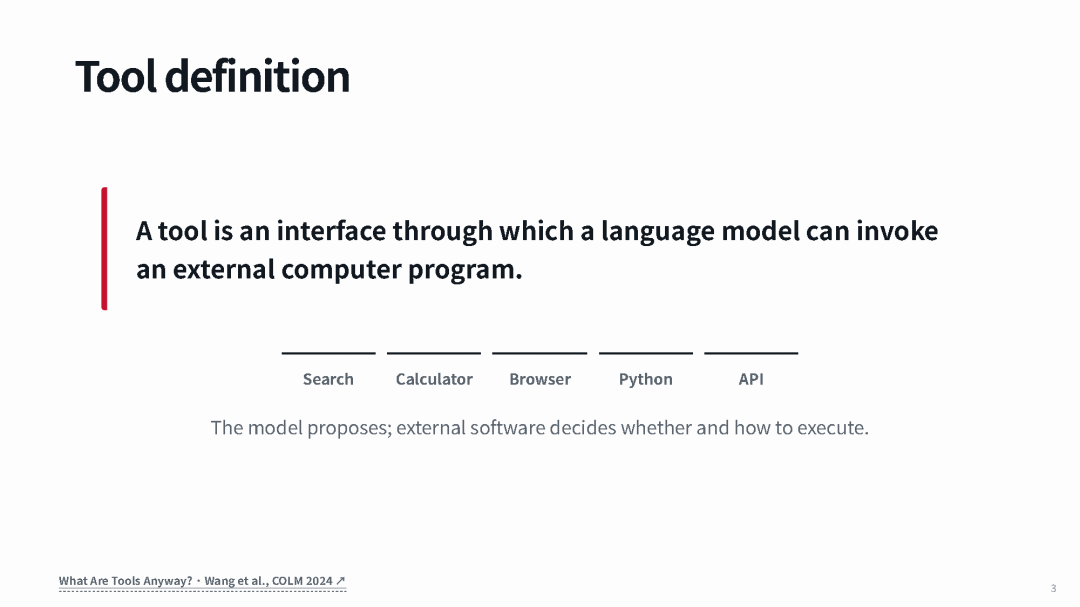
这里有个特别值得记住的分工 — 模型提议,外部软件裁决(The model proposes; external software decides whether and how to execute)。模型吐出来的只是 “我想调 search_web,参数是这个” ,真正要不要执行、怎么执行,是 Harness(框架)说了算。这跟第一讲的 “模型 vs. Harness” 分工是一脉相承的。
**为什么需要工具?**Neubig 归成两类好处(都来自他和学生合写的综述What Are Tools Anyway?, COLM 2024):
扩展(Extend)— 让模型做它根本做不到的事。比如 “四个月前的今天是什么信息” ——模型参数是冻结的,它见过的最新信息就到某个时间点为止,不调外部函数根本无从知道。
辅助(Facilitate)— 模型本来能做、但用工具更省事的事。比如做数学:现在的模型其实算得不错,但你让它乘两个七位数,它得吭哧吭哧推理半天,而计算器一瞬间就出来了。
把这两类展开成一张 “什么时候该调工具” 的场景表,就是这一讲最实用的一张速查表:
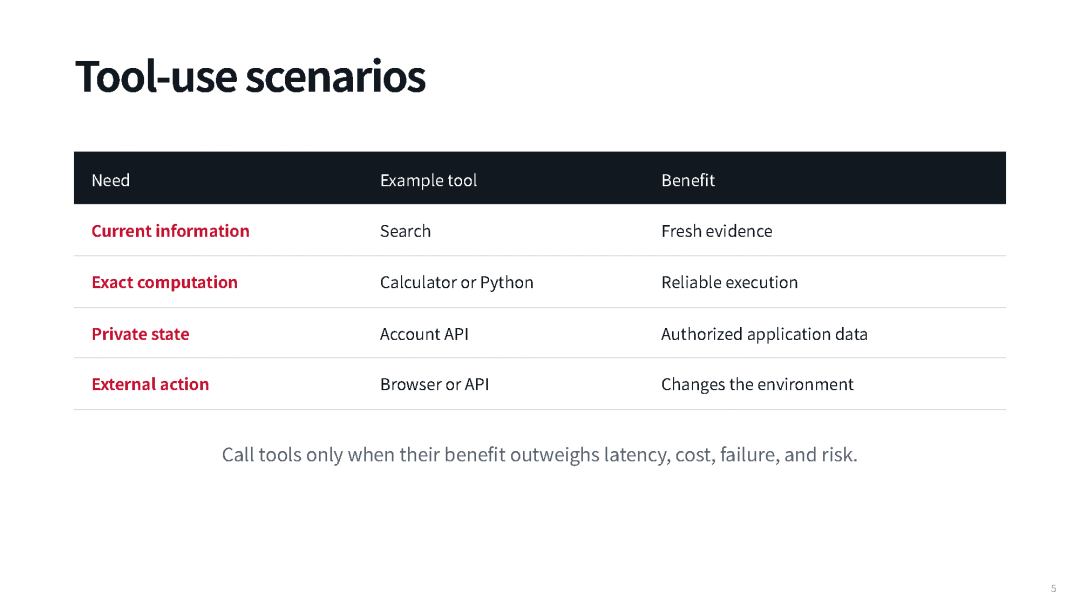
需求 | 例子工具 | 收益 |
|---|---|---|
当前信息 | 搜索 | 新鲜证据 |
精确计算 | 计算器 / Python | 可靠执行 |
私有状态 | 账户 API | 访问授权过的应用数据 |
外部动作 | 浏览器 / API | 改变环境 |
底下那行小字才是重点,我原样翻译:
只有当工具的收益超过延迟、成本、失败率和风险时,才去调用它。
这句话是整张表的 “刹车” 。工具不是越多越好、越勤越好 — 每一次调用都有代价。
ChatGPT 是怎么从 “纯文本” 长成 “什么都能干” 的
Neubig 拿 ChatGPT 举例:它刚出来时字面意义上就是文本进、文本出,唯一能做的就是给你文字回复。现在它成了 “什么都能干的 App”。课堂上他问学生 “你们用 ChatGPT 最多的场景是什么”,答案五花八门:写代码、生成图片、渲染 LaTeX、生成 PDF、接 Slack……
他借这个把常见工具归成几类典型:
文本响应(textual response)— 最“无聊”的一种,就是给你个答案。实现上有两种:要么有个 finish 工具显式说 “我聊完了”,要么模型这一步干脆不调工具,循环自然就结束了。
搜索网页(information retrieval) —也就是大家熟知的 RAG。这里 Neubig 有段很妙的吐槽:这两年语言模型圈老有人喊 “RAG 已死”,但他的看法是:“检索+生成” 这套已经普及到大家根本没意识到自己在用了,它不是死了,是活到没人再单独提它了。
代码执行(code execution)— 扔一段代码去做计算。
图像生成(image generation)— 有个细节很有意思:模型真正发给图像生成 API 的 query,往往和你输入的那句话很不一样,模型会把你的描述大幅扩写。以前在 ChatGPT 下载图片时甚至能看到那段被改写过的 caption。
自定义函数(custom functions)— “帮我买香蕉、牛奶、咖啡” → 调 Instacart API 建个购物车。想接什么就接什么。
顺带一提,Neubig 在这里补了一刀第一讲的定义:
ChatGPT 现在不是聊天 App,它是个 Agent — 因为它会做迭代式的工具调用来回答你的问题 - 这就是 Agent 的定义。
二、代码,是一种“元工具”
讲完常规工具,Neubig 抛出这一讲第一个大观点。
传统做法是:你给 Agent 一张 50、70 个 API 函数的清单,它每一步挑一个来调。但代码是一种特殊的API — 因为代码太有表达力了,你可以把它看成一个元工具(meta-tool)。
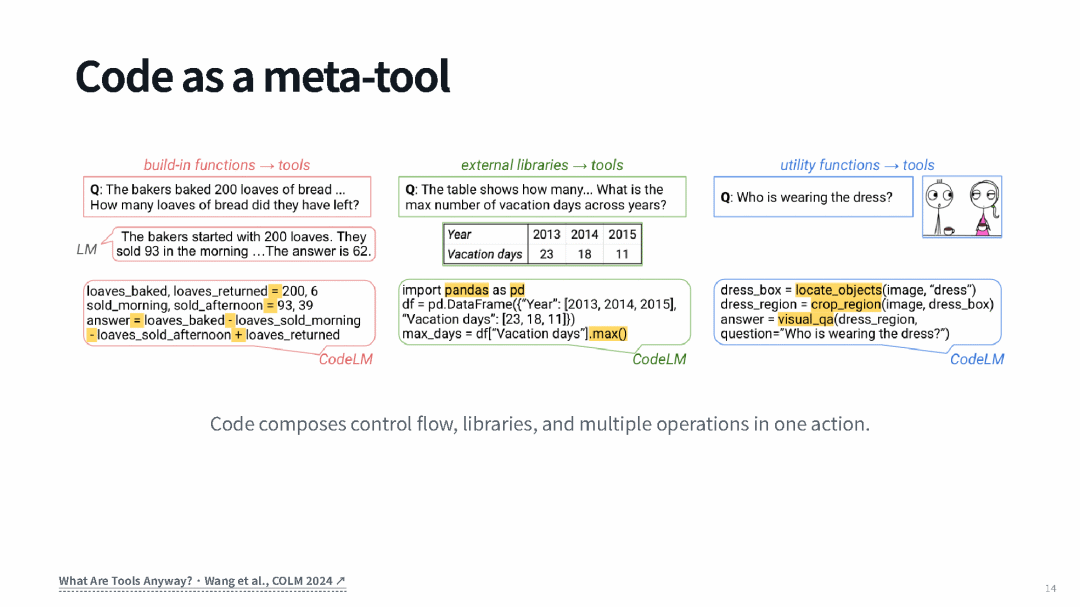
他的拆解很到位:一段代码本质上就是一棵函数调用的树 — “面包店烤了 200 个面包还剩多少”,里面有赋值、有减法、有再赋值…… 而这棵树里还能有循环和其它控制流。更妙的是,你还能 import 外部库 — 一旦你能调 pandas,你就等于一次性打开了 pandas 里所有的工具;你也能写自己的工具函数。所以代码 “以一种全新的方式打开了调用工具的能力”。
CodeAct:不是空谈,有论文有数据
这不是拍脑袋的说法。Neubig 举了自家学生的工作 CodeAct(Wang et al., ICML 2024)。他回忆说,三四年前刚开始用 LLM 造 Agent 时,根本不是这么调工具的。那时候要回答 “哪个国家买某款手机最划算(考虑美、日、德、印)”,你得一步步来:查德国汇率 → 查手机价格 → 换算加税 → 再查下一个国家汇率 → 再查价格…… 来回踩十几步才出结果。
而用代码,你写一个程序一次跑完就行。
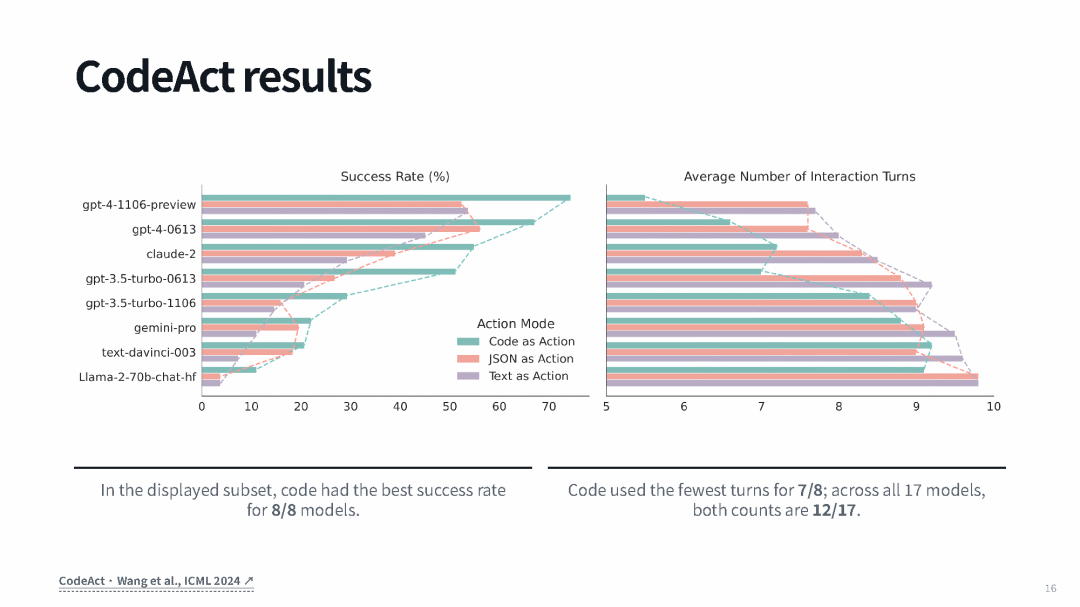
论文的核心结论:用代码调工具,成功率上升、平均交互轮数下降 — 而且这对那些 “传统上并不需要写代码” 的任务也成立。代码就是个好媒介。
代码不是万能药:权力越大,越难约束
为什么大家不干脆全用代码?Neubig 让学生猜代码的坏处,答案很到位:
会卡住 — 写出死循环,你系统里就得有对付死循环的机制。
安全问题 — 他点了一个当下 AI 安全的大坑:Agent 会拉进来一个被投毒(compromised)的库,然后 Agent 被攻陷,你整个系统跟着沦陷。
更难约束、影响更大 — 动作空间太广,难以验证和预测;还能吃更多内存、磁盘、CPU。
所以他的结论是:一旦转向 “用代码调工具” 这种编程式工具调用(programmatic tool calling),你就必须开始认真考虑沙箱、资源限制、权限和审计日志 — 这也是后面安全那一讲要展开的。
代码:表达力强(循环·变量·库)、更难约束(动作空间广、验证不如窄接口精确)、影响更大(文件·网络·进程)。用它,就要配上沙箱、限额、权限、审计。
三、机制:一次工具调用,本质上就是 “另一段 token”
这是第一讲那句 “tool call 不过是另一段模型能预测的 token 序列” 的正式展开。
一个模型的输出,可以是文本续写(“天气是晴天”),也可以是工具续写(一段 里包着 get_weather(...))。而且这两者常常出现在同一段输出里。如果你还记得第一讲的 ReAct,这就是它的样子:先有一段给人看的文字,再来一段真正的工具调用;用推理模型的话,最前面还能再挂一段 “thinking”(很啰嗦、不给用户看的思考)。
工具怎么 “喂” 进模型:定义进,调用出
流程是这样的:你写一个工具定义(JSON Schema 描述的带类型接口),把它连同消息一起通过 chat.completions.create (...) 这类接口发给模型;chat template 会把工具定义和消息一起序列化成模型能读的那一长串 token。
模型看到后,吐出的就是一段结构化的调用内容 — {“name”: “get_weather”, “arguments”: {“city”: “Pittsburgh”}}。注意:调用的内容由模型生成,但那个唯一的 call ID 是 API 响应事后给它挂上去的。
同一个调用,不同模型协议不一样
这一页我特别想让你看看,因为它戳破了一个常见误解:“工具调用是标准化的”。语义上标准,序列化上一点都不标准:
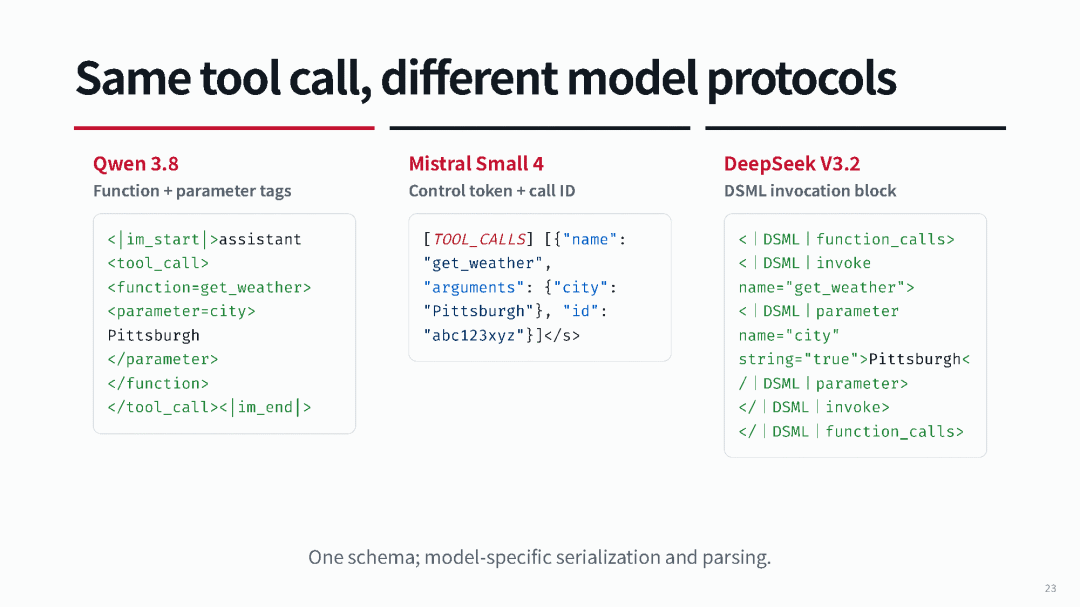
同样是调 get_weather(city=“Pittsburgh”):
Qwen 3.8:用 这种函数+参数标签。
Mistral Small 4:用 [TOOL_CALLS] 控制 token,后面跟一个带 id 的 JSON。
DeepSeek V3.2:用 |DSML|function_calls 这种专门的调用块。
一套 schema,各家模型有各自的序列化和解析方式。
Neubig 强调:这些都是框架帮你实现好、标准化好的(你用对应模型的 chat template 就行)。但他想让你知道 “底下在发生什么” — 因为如果你不懂这层,出了 bug 你会很难受。
结果怎么回来:靠 call ID 配对
模型发起调用时带一个 ID(比如 call_123),工具执行完的结果用一个 role: “tool” 的消息带上同一个tool_call_id 回来。这个配对在并行调用时尤其关键——好几个调用同时飞出去,全靠 ID 认领各自的结果。
这里 Neubig 分享了一个血泪细节:有些头部大模型的 API,如果你的历史里有一个 tool call 没有配对的 tool result,它会直接判定 “这是非法历史”,拒绝再给你生成任何输出。实践中很常见的踩坑是:assistant 刚发起调用,你的程序突然崩了、没来得及写回结果,等你 resume,历史里缺了那个结果 — 大模型就罢工给你看。这是你必须知道的一个坑。
四、约束解码:怎么保证模型不吐出“坏掉的 JSON”
语言模型并不保证生成格式正确的工具调用。最典型的翻车就是 — JSON 少了个右括号,你的解析器直接抛异常,数据拿不出来。
Neubig 说他见过无数人试图 “事后去数括号、缺了就补一个” — 别这么干,那不好玩。正确的做法是约束解码(constrained decoding)。
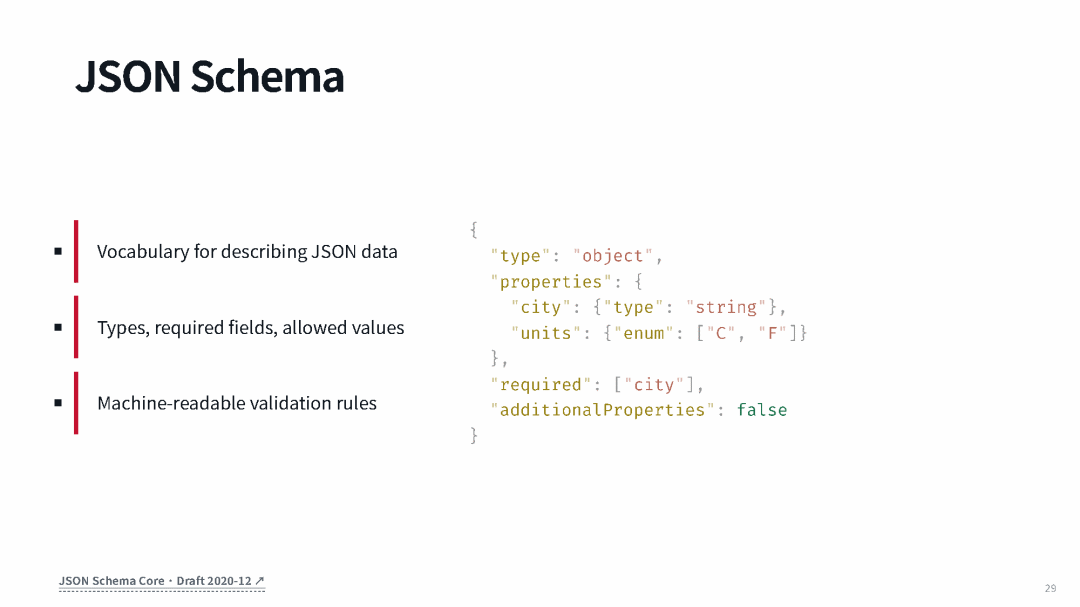
先厘清“约束”到底要管几件事:
语法(Syntax):得是合法 JSON(能 parse,这是底线)。
形状(Shape):该有的必填字段得有。
类型(Types):city 得是字符串。
取值(Values):units 只能是 C 或 F。
而这一切,可以用 JSON Schema 表达:
有一句提醒很关键,Neubig 反复强调:
约束只保证 “形式” — 不保证真实性、权限、工具选择是否恰当、或任务是否成功。 一个能被解析成 Python 的字符串,跑起来照样可能是错的。
从正则到下推自动机:约束是怎么实现的
这一段是这一讲里 “算法味” 最重的部分,Neubig 说得很坦诚 — “如果你觉得这有意思,很好;如果不觉得,那就庆幸有别人替你把它解决了” 。我帮你把链条理顺:
正则表达式 = 正则文法,用有限状态自动机(finite state automaton)就能解析。
但 JSON Schema 无法用正则文法表达,它需要上下文无关文法(context-free grammar)— 因为 JSON 可以任意深地嵌套。
有限状态自动机解析不了上下文无关文法,于是引入下推自动机(pushdown automaton)— 就是给自动机加一个栈。
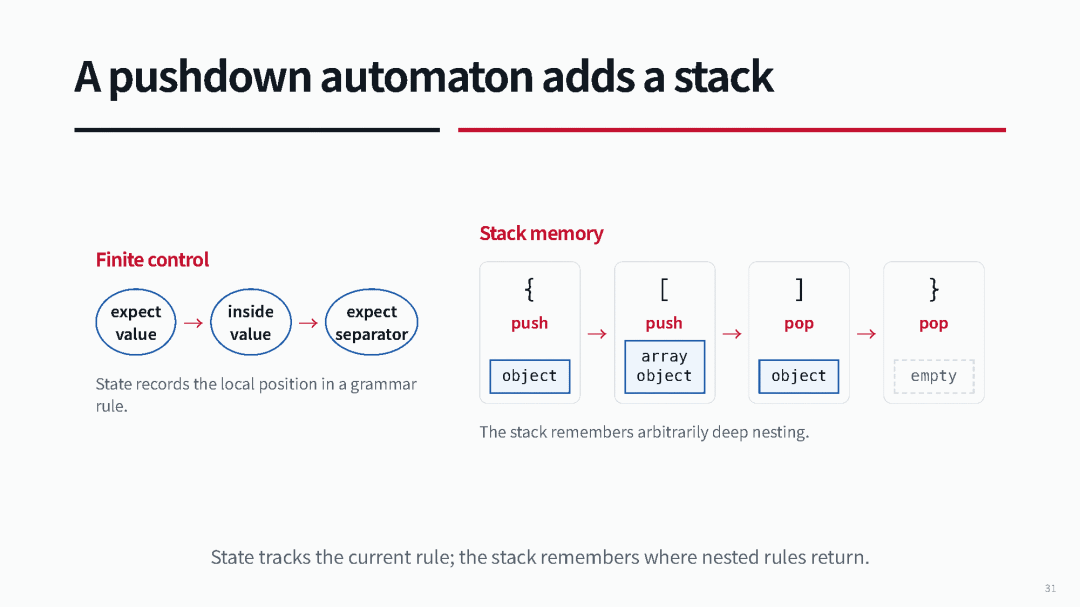
状态负责追踪当前在哪条规则上,栈负责记住嵌套的规则该返回到哪里。 一个记 “局部位置” ,一个记 “任意深的嵌套” 。
具体到解码:每当 LLM 预测下一个 token 的 logits,你就拿文法查一遍 — 合法的 token 记 1,非法的记 0,把所有非法 token 的 logit 设成负无穷,再重新归一化,于是概率只落在合法 token 上。这样就保证生成合法输出。
Neubig 用的例子来自 XGrammar(Dong et al., MLSys 2025,顺带一提这是 CMU 机器学习系的人做的、被各大推理库广泛使用)——它的加速技巧是:有些 token 在任何上下文都合法/非法,预先算好;只有少数 “依赖上下文” 的才即时计算。
一个连约束解码都救不了的极端情况
Neubig 出了个 “很难” 的小测验:即便开了约束解码,什么情况下还是拿不到合法工具调用?
答案是 — token 用完了。模型能生成的 token 有上限,你可能正走在自动机的一条合法路径上、但还没到终止状态,就被截断了,于是只生成了半段 JSON。(他说这理论上可以靠 “预留剩余 token 数、提前收尾” 解决,还半开玩笑地当成 XGrammar 的加分作业留给学生。)
五、怎么把工具暴露出来:REST API 与 MCP
从库函数到 REST API
先分清两个层次。一个库 API(比如 weather_lib.py 里的 get_weather(city, units))是进程内的、带类型的编程接口 — 调用方和函数在同一个进程里,Python 直接提供名字、参数、类型、返回类型。但它还不能远程调用:要变成网络服务,还差地址、协议、序列化和鉴权。
FastAPI 把库函数一键绑成 REST 端点:
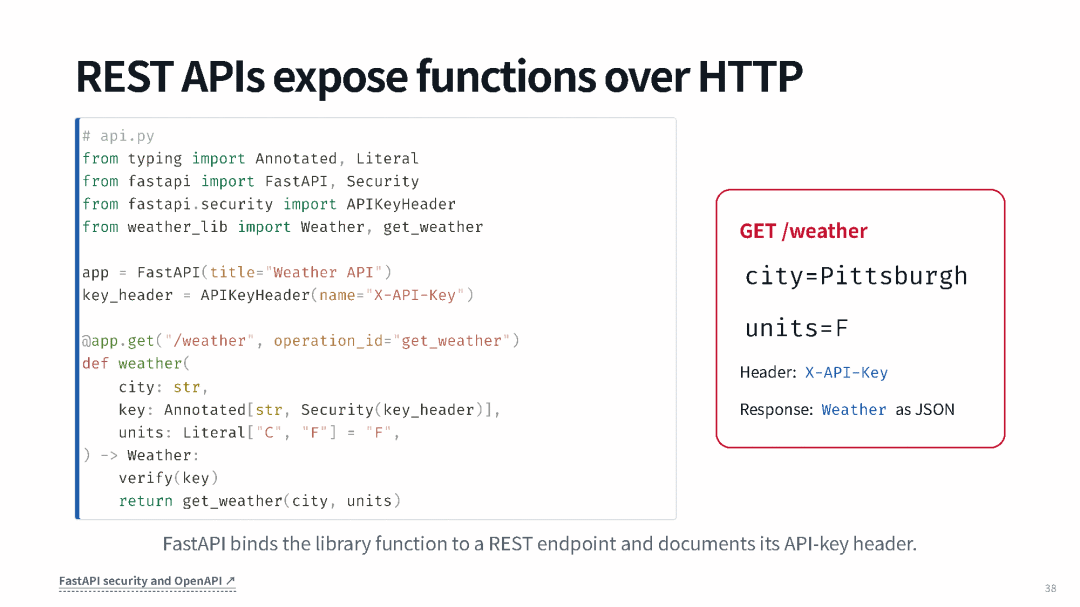
Neubig 点了 FastAPI 的两个好处:一是鉴权 — 加个 API key,没有 key 的人就调不了你的接口(保护你的私有数据);二是免费得到 JSON Schema — 你整个 API 能被表达成一份 OpenAPI 描述(里面嵌着 JSON Schema),这份描述可以原样喂给语言模型,模型就知道哪些调用是允许的。
他还提了一嘴编程 Agent 最朴素的调法 — 直接用 curl。有 bash 权限的 coding agent 可以读完 API 描述、拼出命令、用环境变量传 key 直接发 HTTP。简单,但有个隐患:Agent 的 shell 里就握着那个 API 凭证,一个有 shell 权限的 Agent 可能读到甚至误用这个 secret。这就引出了 MCP。
MCP:Neubig 自己一开始也没看懂为什么需要它
**MCP(Model Context Protocol)**是 Anthropic 大约一年半前推出的、给模型提供额外上下文的标准协议。Neubig 很坦白:
“我第一次看到 MCP 时,想的是 为什么要搞这个?我不懂为什么需要它' — 让 Agent 直接调 API 不就好了,我们本来就有调 API 的好办法。”
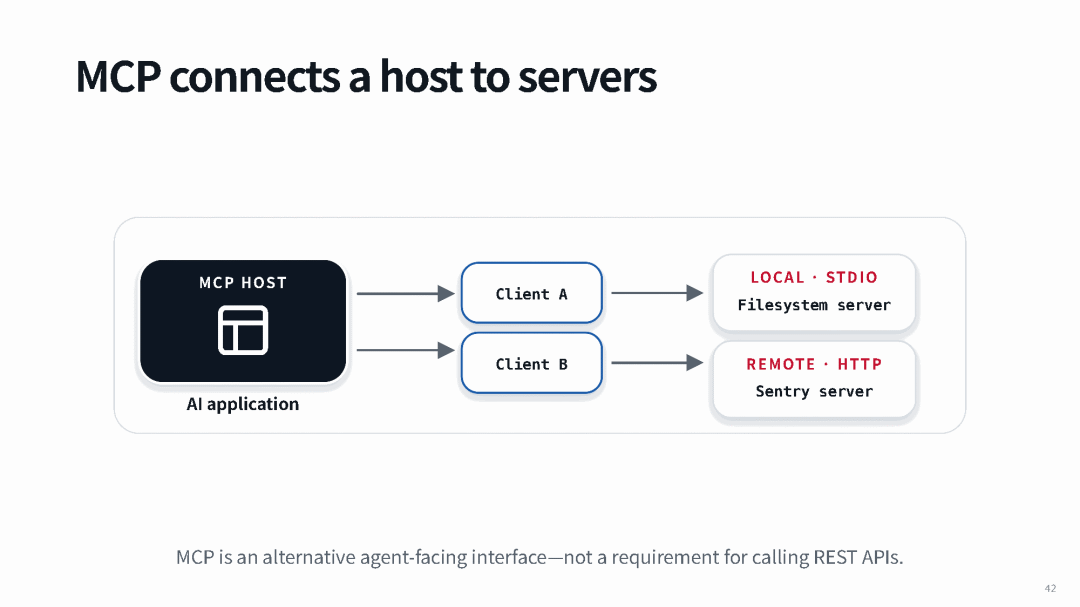
他后来想通了 MCP 真正的价值:多一层安全(凭证代理 / credential brokering):
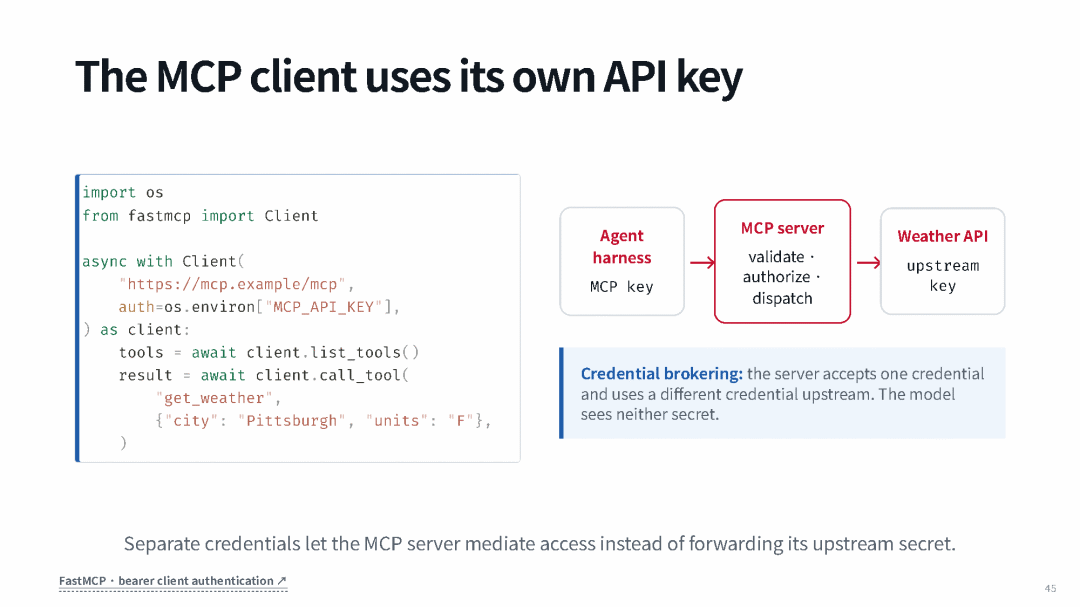
关键机制是两把钥匙分离:
MCP API key:给运行 Agent 的进程,用来认证进入 MCP server。
Upstream API key(比如你的 GitHub token):只给 MCP server,绝不给 Agent。
**为什么重要?**Neubig 举了个让全场笑出声的例子:如果你把 GitHub token 直接给 Agent,结果 Agent 哪根筋不对,把它 push 到了你的公开仓库 — 账号沦陷、仓库全被装上恶意软件。所以你要给 Agent 的,是一个 “即使泄露也相对无害” 的东西(MCP key),真正的凭证由 MCP server 保管、在上游那侧使用。
把凭证分开,让 MCP server 去 “中介” 访问,而不是把上游 secret 直接转发给模型。
他还顺带提了两点:FastAPI 有个对应物 FastMCP(可以把一份 REST 的 OpenAPI spec 直接转成 MCP),以及有官方 MCP registry 和一堆按热度排名的 MCP 站点可以找现成的 server。
最后用一张表把 REST API 和 MCP 摆一起对比:共享 schema,契约不同:
维度 | OpenAPI / HTTP API | MCP |
|---|---|---|
共享的部分 | 名字、描述、结构化输入的 JSON Schema(两者一样) | 同左 |
发现(Discovery) | 拉一份 OpenAPI 文档 | 运行时调 tools/list |
调用(Invocation) | HTTP 动词 + 路径 + 参数 | tools/call,走 MCP transport |
鉴权 | 客户端认证到 API | 客户端认证到 MCP;上游鉴权单独一层 |
范围 | 描述 HTTP 操作 | 还支持 resources、prompts、扩展 |
OpenAPI 描述的是一个 Web API;MCP 标准化的是 “一个 AI host 如何发现并调用能力” 。
六、并行工具调用:为什么更贵的模型反而更便宜
工具一个一个串行调,太慢了。举例:生成→天气→生成→日历→生成→航班→生成,每段 0.8~1.2 秒,加起来约 6.4 秒。
但如果这几个调用互相独立,可以塞进同一次生成、共享一次等待:
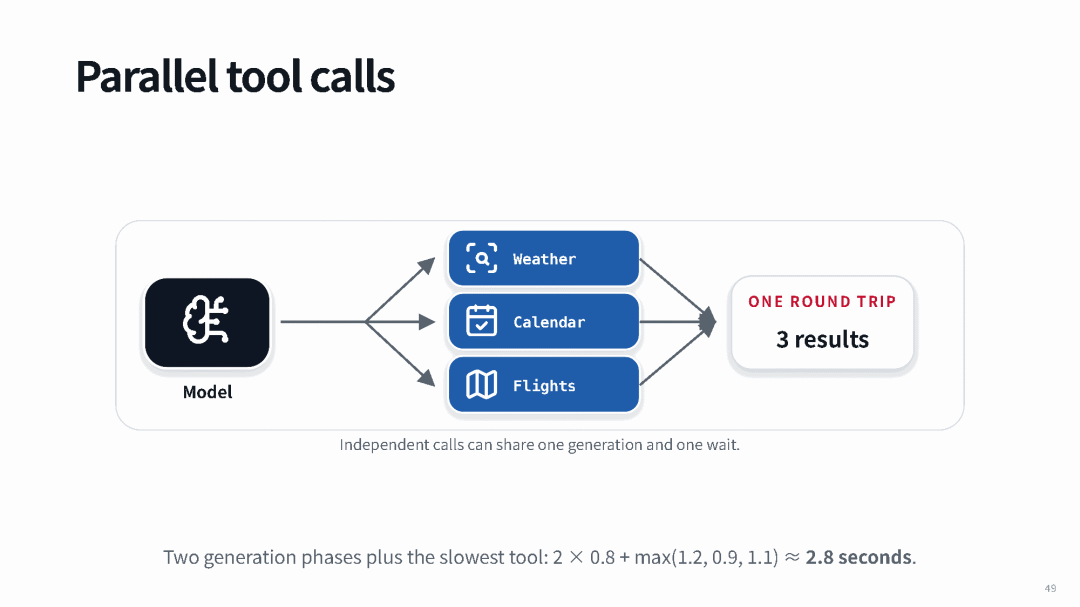
同样几个调用,并行后从 6.4 秒压到约 2.8 秒。实现上很朴素:在一次 assistant 响应里塞多个 tool call 块,然后用 asyncio.gather 之类的同时执行、结果回来时靠 call ID 认领。
但有条铁律:只能并行没有依赖的调用。
✅ 可以并行:查匹兹堡天气、读今天日历、查航班状态(互不相干)。
❌ 必须串行:先找到 customer ID → 用它查订单 → 退掉选中的订单(后一步依赖前一步)。
这里 Neubig 抛了个有意思的 “悖论”,也是这一讲我最想让你记住的一条实践经验:
在按任务计费的口径下,更贵的模型反而可能更便宜。
两个原因:一是更贵的模型更聪明,更快挑到对的解法;二是更新的模型并行工具调用做得好得多 —— 它们会一次性发一堆调用(同时看多张图、同时写多个文件)。
而为什么模型突然(大约半年前起)就变得擅长并行调用了?课堂上有学生一语中的:强化学习逼的。RL 重奖 “快速完成任务”,你要是在任务执行时长上加个很重的简洁性惩罚,模型自然就学会了大量并行调用。
七、怎么评测工具使用
最后一块,Neubig 先声明:这里不评测端到端的 agentic 任务,只评测 “语言模型的工具可用性” —— 因为这是模型擅长 agentic 任务的前提。
最出名的基准是 Berkeley Function-Calling Leaderboard(BFCL),已经出到 V4:
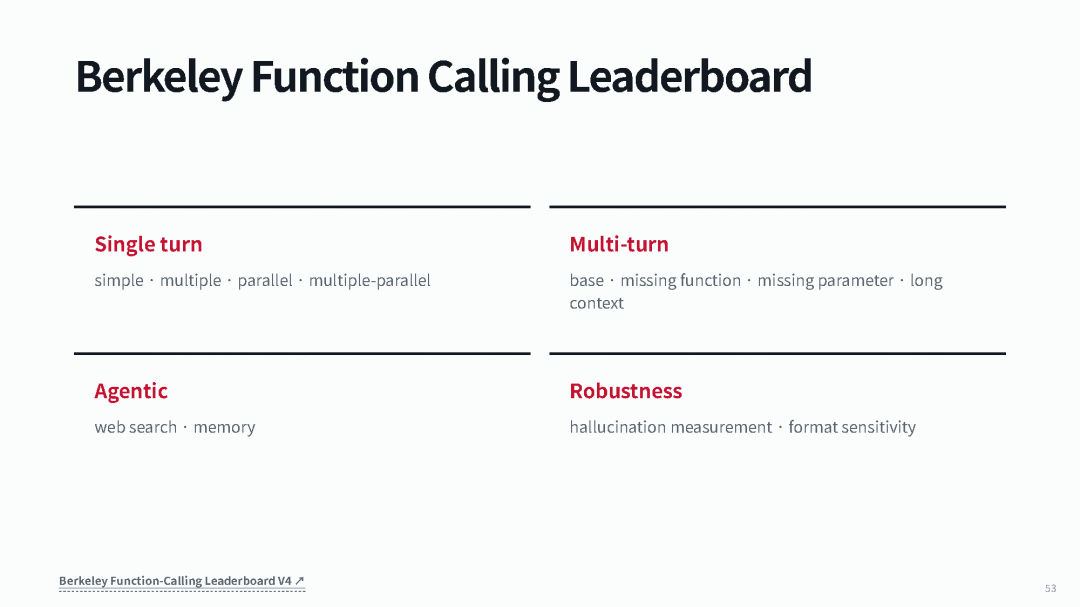
它从 V1 的单轮工具调用,一路演进到多轮、agentic 工具调用,还专门测鲁棒性 —— 参数幻觉、格式敏感性(就是前面讲的那些不同模型格式)。
评测要评 “整个栈”,分四个层次
Neubig 给了一张我觉得非常实用的分层评测表——从 “选没选对工具”一直问到 “任务有没有达成”:
层次 | 问的问题 | 例子指标 | 需要执行吗 | 典型失败 |
|---|---|---|---|---|
选择(Selection) | 工具选对了吗? | 精确率 / 召回率 | 否 | 漏调或多调 |
参数(Arguments) | 值填对了吗? | AST / schema 匹配 | 否 | 字段或值错 |
轨迹(Trajectory) | 顺序对吗? | 序列成功率 | 通常需要 | 依赖关系错 |
任务(Task) | 目标达成了吗? | 端到端成功率 | 是 | 看似合理的错误答案 |
而且质量不止“对不对”,还有运维维度:
效率(Efficiency):延迟、调用次数、token、成本 - 一个正确的 Agent 也可能慢到、贵到没法用。
可靠性(Reliability):超时、重试、部分失败 - 要在真实的 provider 行为下报告成功率。
安全(Safety):策略、权限、副作用 - 要测对抗性输出和有后果的动作。
一个反直觉的发现:同一个模型,换个 provider 错误率差 1000 倍
这一讲的收尾数据很震撼。Neubig 拿了 OpenRouter 的一个基准 —— 同一个模型,唯一变量是谁来给你 serve 这个模型:
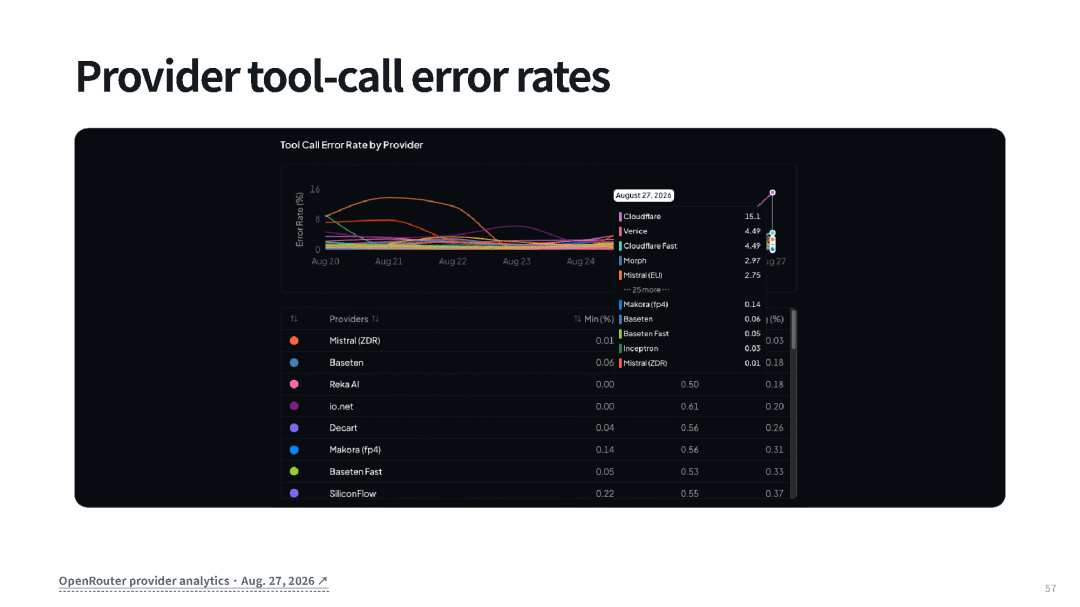
结果:错误率从15%一路到0.01%~0.05% —— 差了上千倍。你以为“同一个模型不管谁提供都一样”,实际上天差地别。Neubig 和学生一起分析了原因:
推理/解码算法不同 — 尤其是量化等级。他的经验是 FP8(默认量化)的工具调用错误远少于 FP4;FP4 压得太狠,给 provider 省了钱,但通常是个更差的模型。
投机解码(speculative decoding)— 无损的不该有影响,但如果是有损的投机解码,就可能带偏结果。
是否用了约束解码 — 很多 provider 自己从头实现推理算法,有的用 vLLM/SGLang(支持基于文法的解码),有的干脆没实现约束解码,全靠模型裸奔。
还有个 “无聊但真实” 的原因 — provider 本身不稳定,时不时宕一下,调用就失败了。
这条对实践的启示很直接:选模型只是一半,选 provider 是另一半。
结语:工具使用是一个分层系统
Neubig 用一句话收束整讲,我原样翻译他的 takeaway:
工具使用是一个分层的系统。
能力层:工具带来检索、执行、生成、应用 — 它们才是让 Agent 成其为 Agent 的东西,但这不是免费的。
机制层:把 schema 加进 prompt,模型吐出调用,你负责验证、分发、按 ID 配对结果。
约束层:可以加基于文法的解码来保证格式 — 但它不保证语义正确(能 parse 的 Python 照样可能是错的)。
接口层:直接 REST 调用、或 MCP。
编排层:一堆系统负责编排依赖、处理并发、以及评测。
这一讲和第一讲接得严丝合缝:第一讲说 “Agent = 模型 + Harness 的循环”,这一讲就把循环里最关键的那根管子 — 工具调用,从 “是什么” 拆到 “怎么造、怎么保、怎么评”。而且它直接对应第一个作业 — 你要亲手搭一个 Agent harness,就绕不开今天讲的这些坑。下一讲,会转向长上下文的上下文管理。
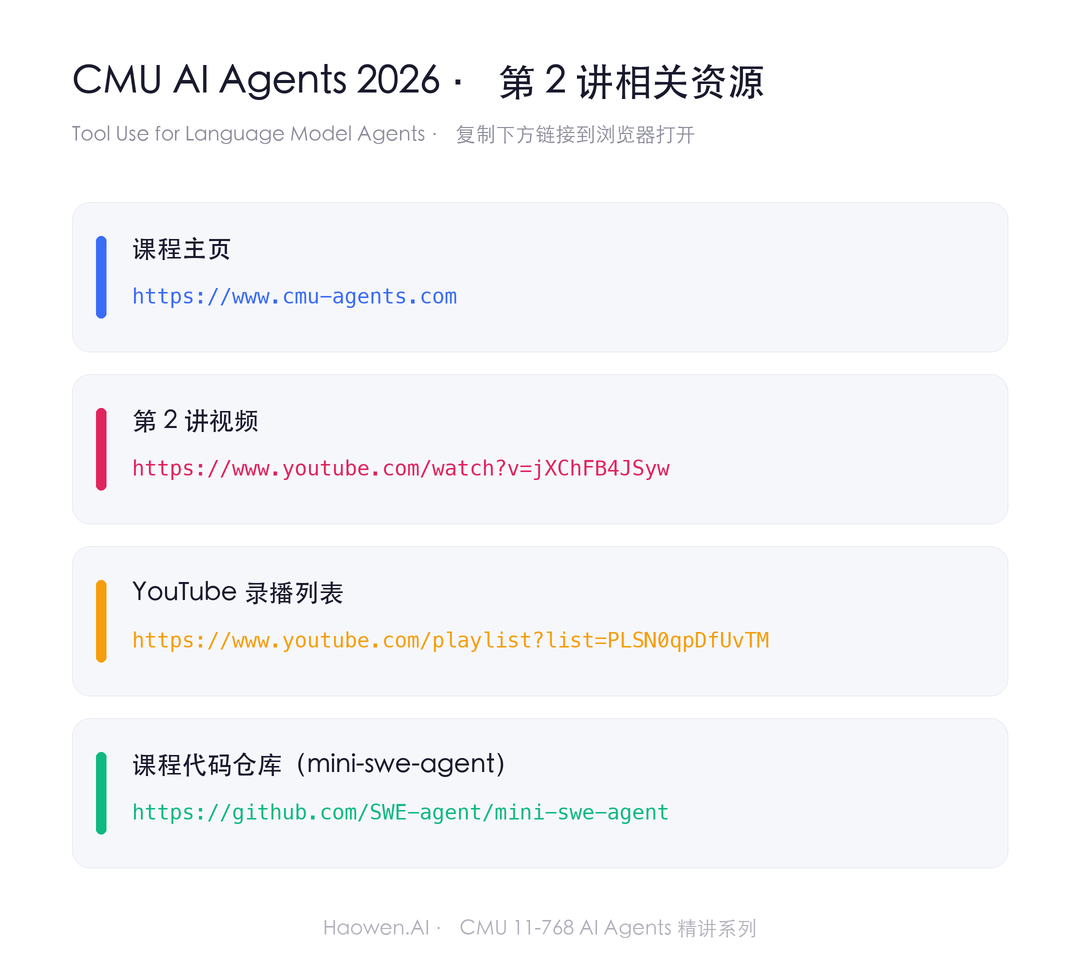
如果你也想认真啃一啃“Agent 到底是怎么造出来的”,这门课的全部材料都免费公开:
朋友们,我们下一讲再见!
本文首发于 Haowen.AI 微信公众号。如果这篇分享对你有启发,欢迎点赞、收藏、转发给同样在学习路上的朋友。
雁评
真实、有观点的好评或吐槽,欢迎分享你的使用体验。