第三讲:智能体的长上下文建模
精读卡耐基梅隆大学AI智能体公开课第三讲,讲解长上下文建模的推理服务栈、架构、训练、KV缓存与上下文压缩。
在上一讲(语言模型智能体的工具调用)里,我们跟着 Graham Neubig 把**Tool Use(工具调用)**拆开精读了一遍,讲清了 Agent 是怎么从「只会说」跨到「能做」的:模型吐出结构化的工具调用,框架负责验证、分发、按 ID 配对结果。(对整门课还不熟悉的朋友,可以先看看这篇课程系列简介。)
但工具用得越顺,就越会撞上一个新问题——上下文(context)越堆越长。你和一个编程 Agent 聊上大半天,它的历史记录能撑到几十万 token。第三讲就来正面回答这件事:当 Agent 的历史不断增长时,它凭什么还能正常工作、系统又凭什么供得起?
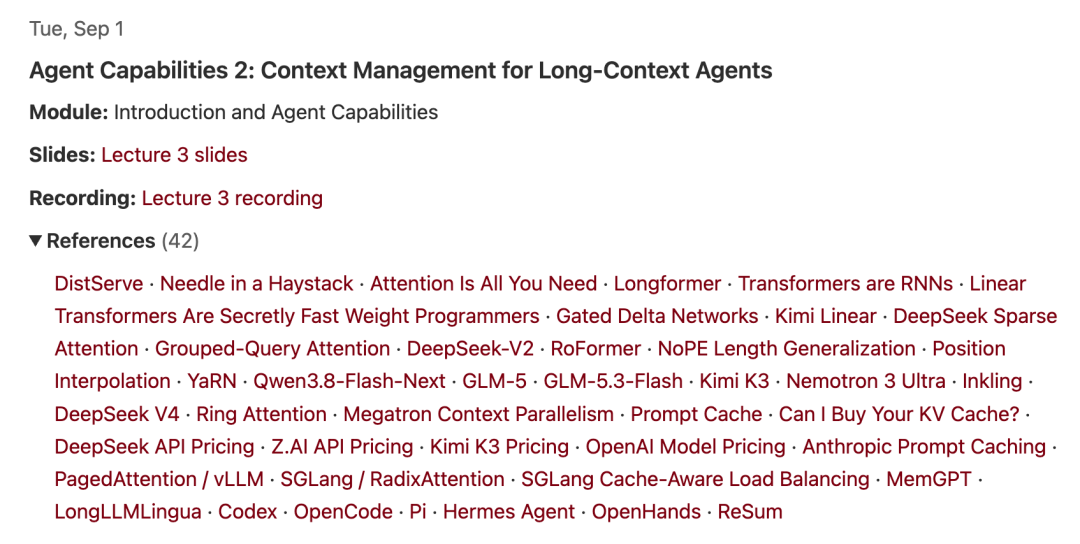
Neubig 一开场就点了题,我原样阐述他的框定:
今天讲的很多东西其实是更通用的 LLM 知识,但长上下文对 Agent 太重要了,而且在很多 LLM 先修课里讲得并不透 —— 所以我今天要讲得细一点。
这一讲的信息量极大,从「上下文为什么会爆」,一路讲到推理服务、架构、训练、缓存、压缩五大块。我把整场录播和讲义啃了一遍,下面带你把干货过一遍。
一、先看清问题:Agent 的上下文,是怎么爆炸的
Neubig 用一张特别朴素的图说明了核心矛盾——历史是线性增长的,但你要处理的 token 总量却是二次方增长的。
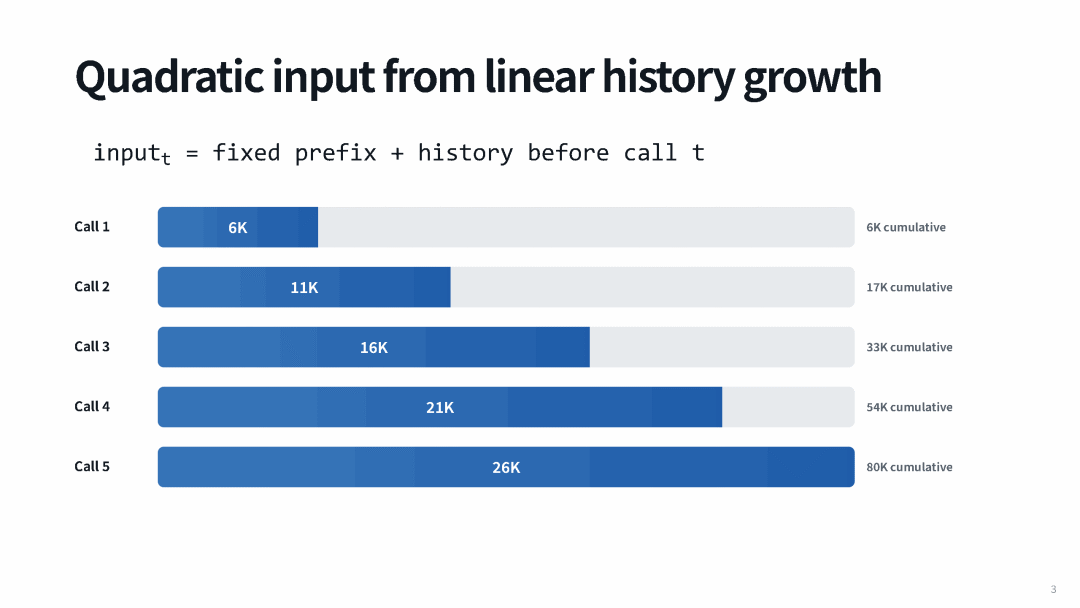
道理很简单:Agent 每走一步,都要把之前的整段历史重新喂进模型。假设每一步新增 5 token,第 1 步 6K、第 2 步 11K、第 3 步 16K……单看历史是线性涨的;但因为每一步都要重新处理一遍前面的全部,累计处理的 token 数就成了二次方。Neubig 说他自己用编程 Agent 连续干过好几天,“你完全可以想象它能涨到多大”。
那为什么 Agent 的 prompt 会这么快就变长?他拿自家编程 Agent OpenHands的真实数据做了拆解——1500 个会话、平均每个会话 77922 token:
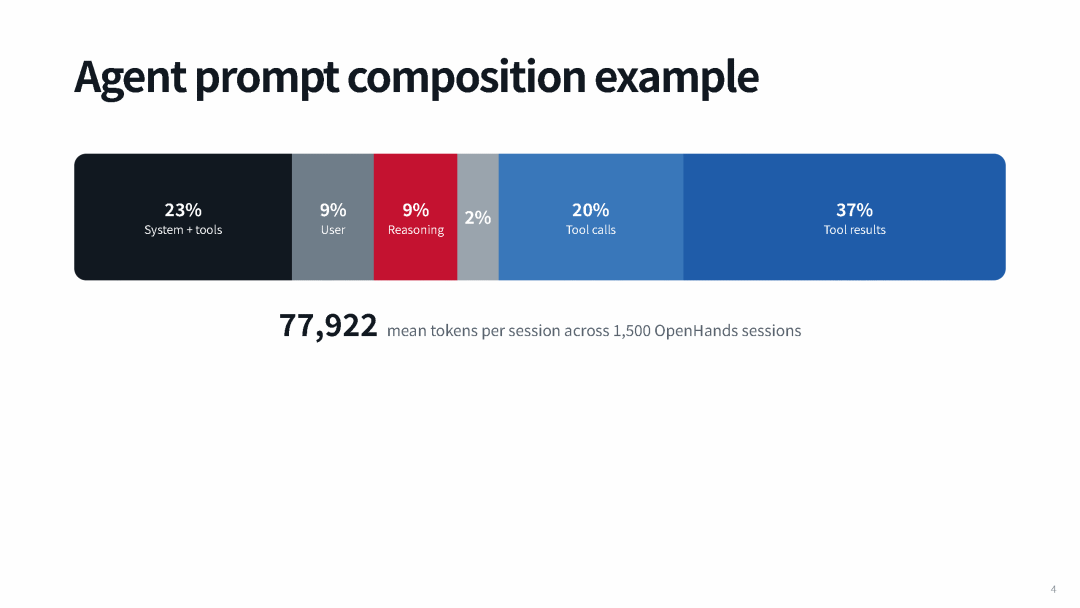
系统提示 + 工具描述:23% —— OpenHands 的系统提示大约 15000~18000 token,因为 “我们对该怎么干活非常有主见”。
用户消息:9% —— 初始任务加后续补充。
推理 trace:9%,模型直接回复用户:只有 2%。Neubig 的调侃很到位:模型花在“思考”上的 token,是花在“跟你说话”上的五倍。
工具调用:20%(写代码、读代码……),工具结果:37%(读文件的返回等等)。
每一步都要把这一大堆东西累加进去,涨得当然快。
看清了增长,就能引出这一讲的两大挑战 —— 这也是贯穿全场的主轴:
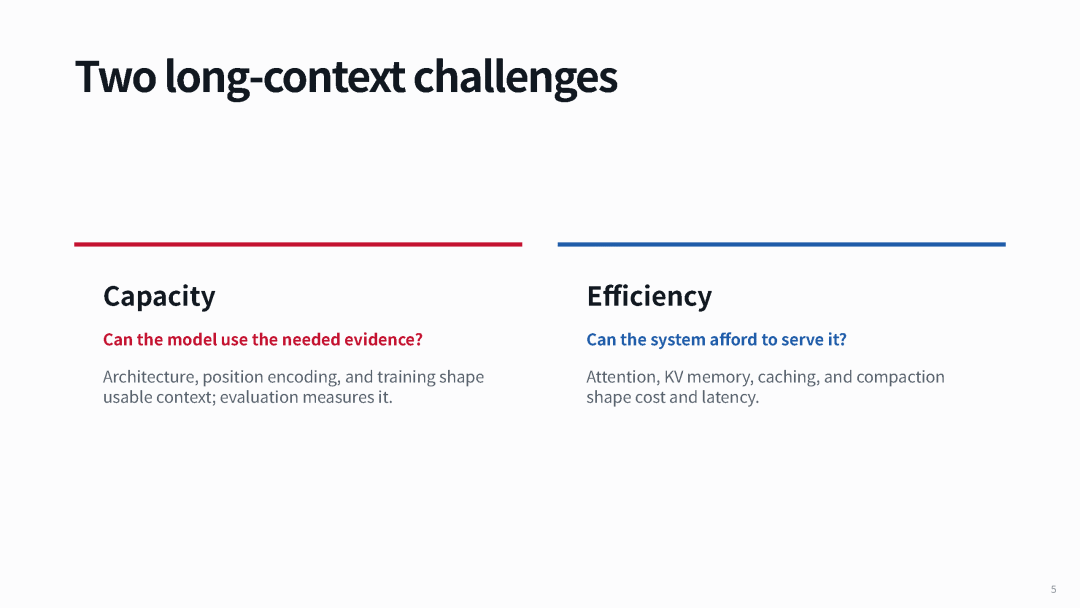
容量(Capacity):模型能不能真正用上它需要的那段证据?
效率(Efficiency):系统能不能负担得起把它服务出来?
这两条线一条管 “用得动”、一条管 “供得起”,后面所有技术都可以归到这两栏里。Neubig 特别提醒:别把“能秒级返回”当理所当然 —— 把一个数万亿参数的模型,在几秒内一遍遍服务给(比如 Codex 那样的)2500 万日活用户,“是相当惊人的工程壮举”。
二、推理服务栈:prefill、decode 与那些衡量指标
要理解长上下文的成本,得先懂推理是怎么跑的。Neubig 把它拆成两个阶段:
Prefill(预填充,也叫编码):把你输入的所有 token 一次性处理,算出每个位置的 key/value。计算密集,延迟随 prompt 长度增长。
Decode(解码):拿着 prompt 的 KV,一次生成一个 token,再把新 token 的 KV 追加进去。串行、受显存带宽限制,每个输出 token 一步。
在此之上,衡量一个服务系统好不好,有几个关键指标:
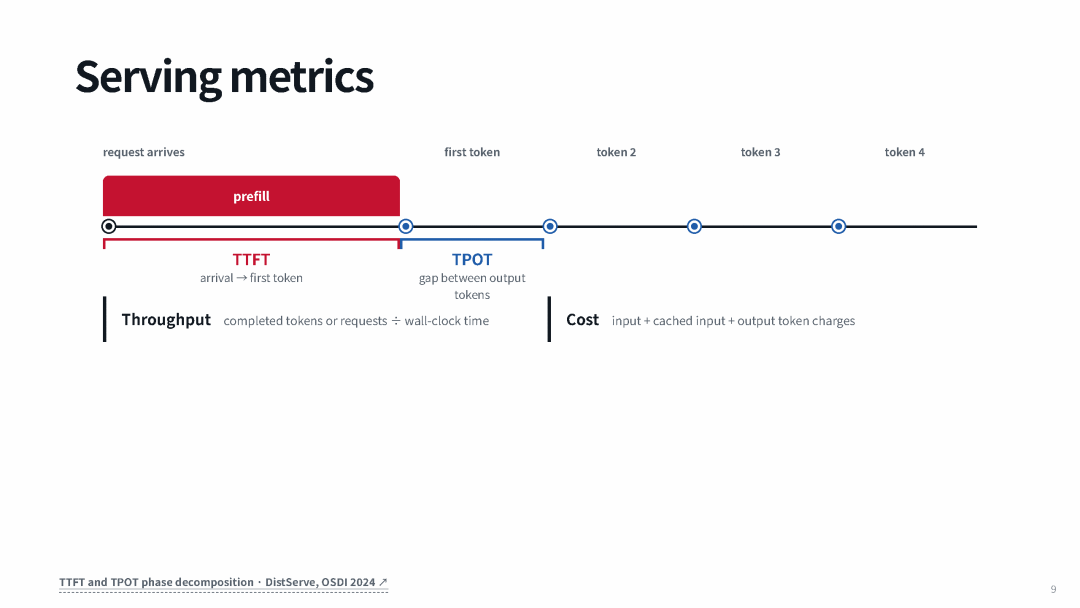
TTFT(首 token 时间):从你敲下问题到看到第一个字的等待。输入越长,TTFT 越高 —— 这就是为什么长输入的 ChatGPT 半天才开始蹦字。
TPOT(每 token 时间):蹦字过程中每个 token 的间隔。Neubig 举了 OpenRouter 的例子:同一个模型,不同 provider 的 TPOT 能差出几十倍——有的每秒才 3 个 token,有的能到几百。
吞吐(Throughput)与成本(Cost)。
他还点了一个很实际的权衡:如果你在编程 CLI 里跟 Agent 交互式干活,你极度在意 TTFT/TPOT;但如果是让 Agent 挂在后台跑一整夜的任务,你可能完全不在乎。他自己开公司服务编程 Agent,provider 常问的第一句就是“你更在乎哪个,我们好帮你优化”。
广告位≠真本事:needle-in-a-haystack
讲完效率,Neubig 转到容量这一侧,抛出一个“老派但经典”的例子——大海捞针(needle-in-a-haystack)评测:
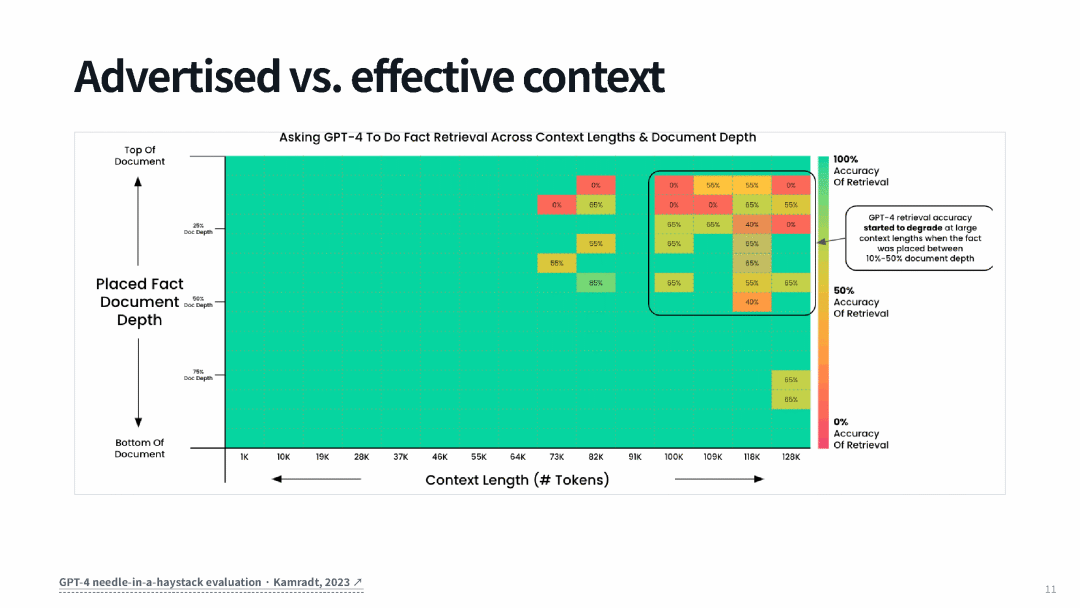
做法很怪但很说明问题:把一大堆 Paul Graham 的文章塞进上下文,中间偷偷插一句 “旧金山吃三明治最好的地方是某某某”,然后问模型 “旧金山哪里吃三明治最好”。把上下文越拉越长,弱模型就开始在超长上下文里答错。常用的进阶基准是 RULER 和 HELMET。
一句话:就算你的服务系统能吞下一百万 token,也不代表模型能有效用上这一百万 token。
Neubig 顺势问学生:“你们长时间用编程 Agent,见过什么常见的失败?”——学生答 “会忘掉前面的上下文”。他补了个真实惨案:有人明确说 “不要删这个”,Agent 干着干着把前文忘了,还是把它删了。在 Agent 这种 “用户不断增量下指令” 的场景里,这个问题格外致命——这也是后面所有技术要解决的根本痛点。
三、架构:把二次方计算 “砍” 成线性
标准注意力是全局的——每个 token 都要和序列里所有 token 两两比较,代价是 O(n²)。
Neubig 做了个心算:现在 SOTA 模型的上下文动辄一百万 token( “没人想当那个别人都上百万、就你 256K 的模型” )。一百万长度的序列,两两比较是多少次?—— 一万亿次。而每一次比较都要做大向量乘法,“这是单条序列就要吃掉的巨量算力”。
解决思路几乎都是同一招:给每一步的比较次数加一个常数上限,把 O(n²) 压成 O(w·n)(w 是那个上限,不一定是窗口)。由此分出局部模型(上限落在局部窗口内)和全局模型(可跨整段传信息)。而当今几乎所有主流模型都是混合模型(hybrid)—— 多层便宜的局部计算,穿插一次全局计算。
Neubig 拉了一张 6 个 SOTA 开源模型的对比表,这是这一段的全景图:
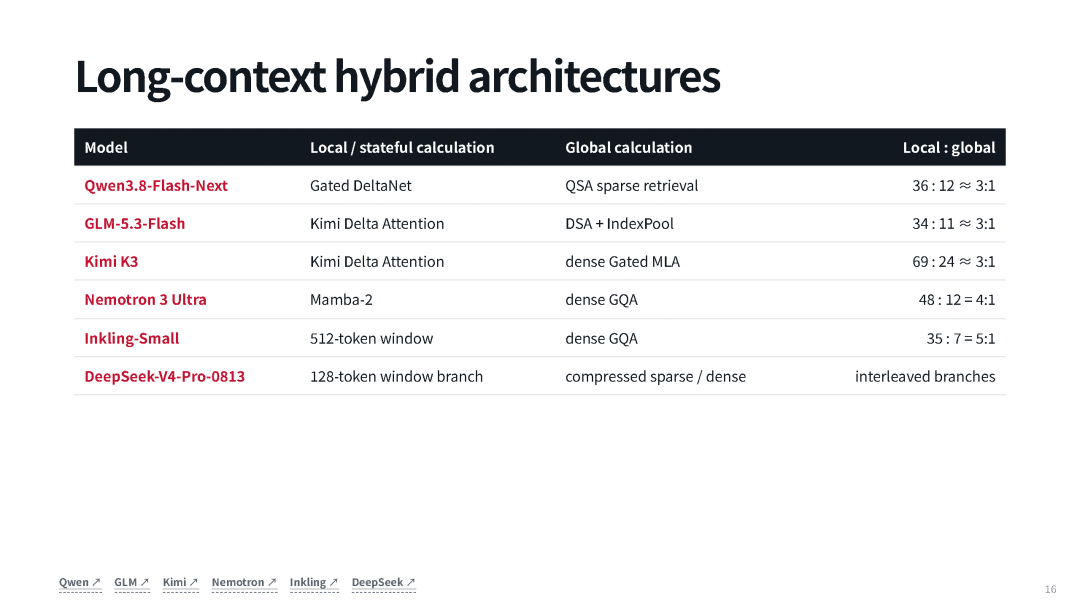
规律很清楚:局部机制 + 全局机制,比例大约 3:1 到 5:1。局部这一档,各家用的是各种 “线性/循环” 变体;全局那一档,要么稀疏、要么稠密。Neubig 说他不会每个都讲透,但会讲清四类反复出现的机制:
1)滑动窗口注意力(Sliding-window attention)
最简单的一种。把序列切成块,每个 query 只能注意到当前块 + 固定数量的前几块(比如各 512 token)。
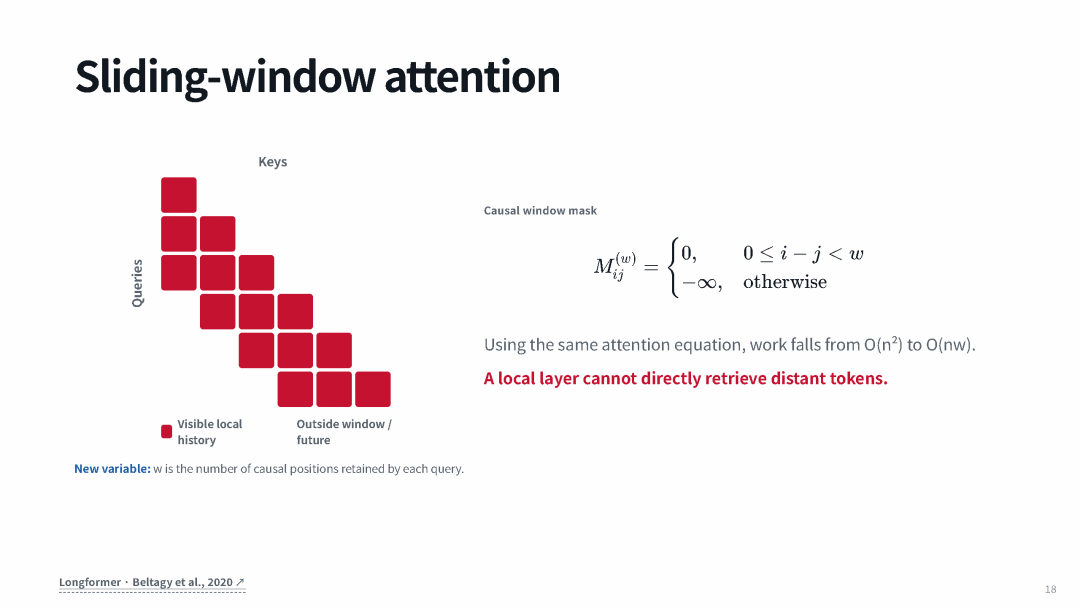
它的妙处在于多层叠加:第一层每个块只看到前一两个块,但下一层里“前面的块”本身又带着它们前面块的信息——于是窗口逐层扩张,信息还是能慢慢传远。不改注意力方程,代价却从 O(n²) 降到 O(nw)。
2)线性注意力:把注意力变成 “能在线更新的状态”
这是当今更流行的一路。核心思路是去掉 softmax。
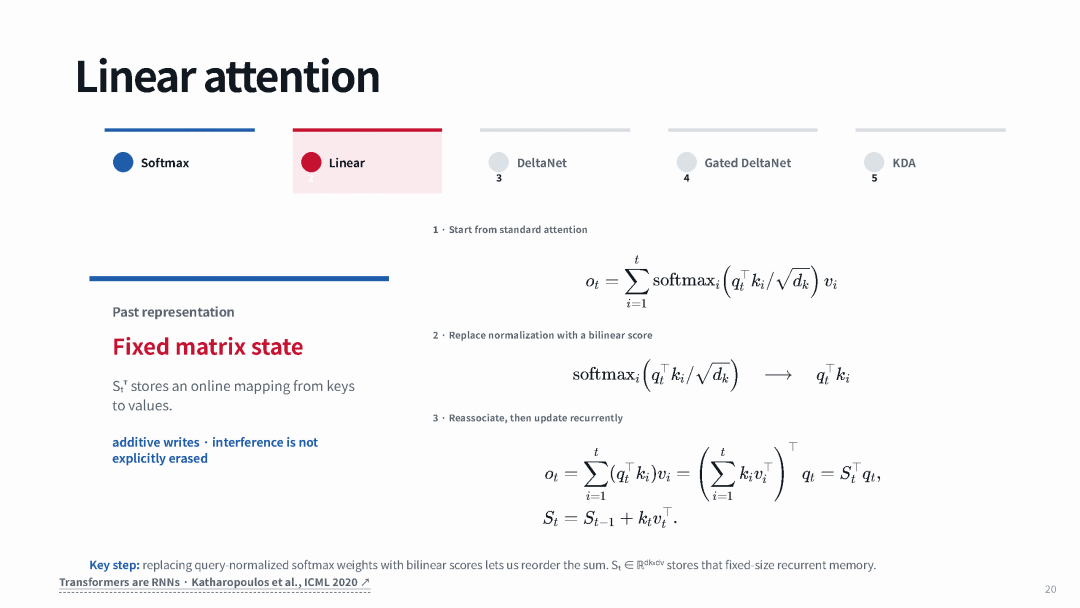
softmax 之所以贵,是因为它要取指数再归一化,逼着你必须展开所有 query-key 乘法,吃满二次方。线性注意力的做法是:把 softmax 拿掉,只留 query·key 的点积,这样求和顺序就能重排——原本“每个 query 对每个 key”的两两计算,变成维护一个固定大小的状态矩阵 S,每来一个 token 就 S = S + kvᵀ 递归更新一下。
它把 O(n²) 直接干成了 O(n),连 w 项都没有——因为每一步都只基于上一步的状态更新。模型这时就变成了一个 RNN。
代价是什么?Neubig 很坦白:这是个表达力更弱的函数。softmax 那个非线性,恰恰是注意力能聚焦到相关的少数几个 token 的卖点,而你把它拿掉了。于是有一系列改进,想在保持线性的同时把表达力找回来——这就引出 DeltaNet 家族:
DeltaNet(讲义未单列页,概念承上):不再无脑累加,而是先读出当前 key 对应的记忆预测、算出误差,只沿着这个 key 的方向做定向修正 ——写入的是 “预测误差”,而不是整块 value。
Gated DeltaNet(门控):线性注意力有个毛病 —— 很久以前一个 “很怪的 key”,可能对未来产生过大影响,且没有机制擦除。解决办法是加一个衰减项 α:每一步先让整个记忆矩阵衰减一点点,再做定向修正。
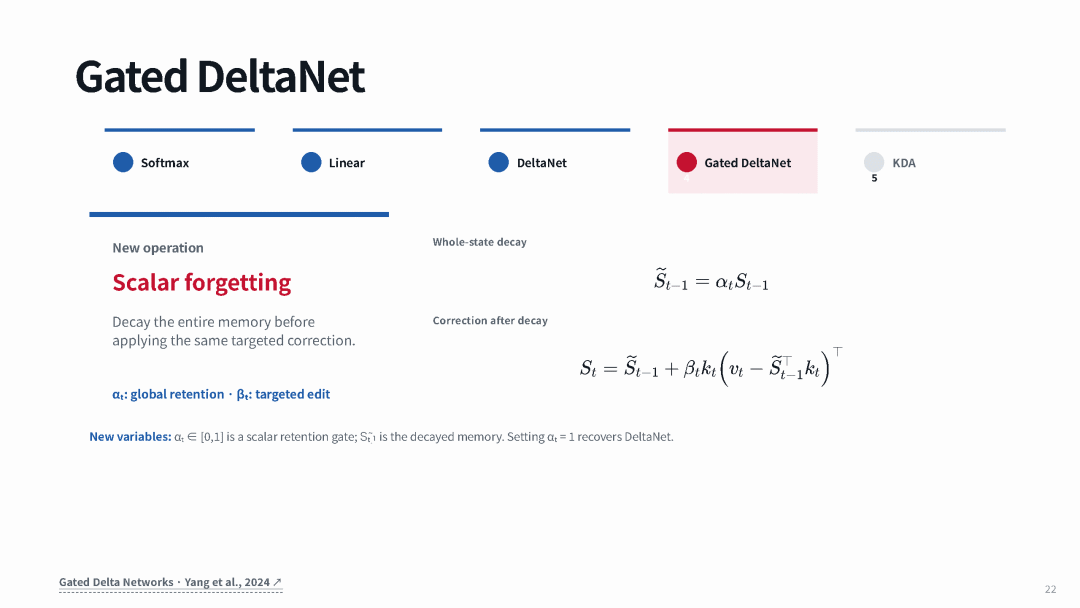
衰减越强,越快忘掉久远的上下文,你就能调节它 “更局部还是更全局”。Gated DeltaNet 用在 Qwen 系列,是目前较流行的做法之一。
KDA(Kimi Delta Attention,逐通道衰减):GLM 和 Kimi 用的是更有表达力的版本 —— 把标量衰减换成逐元素(per-channel)衰减,让 key 空间里每一维都有自己的记忆寿命。
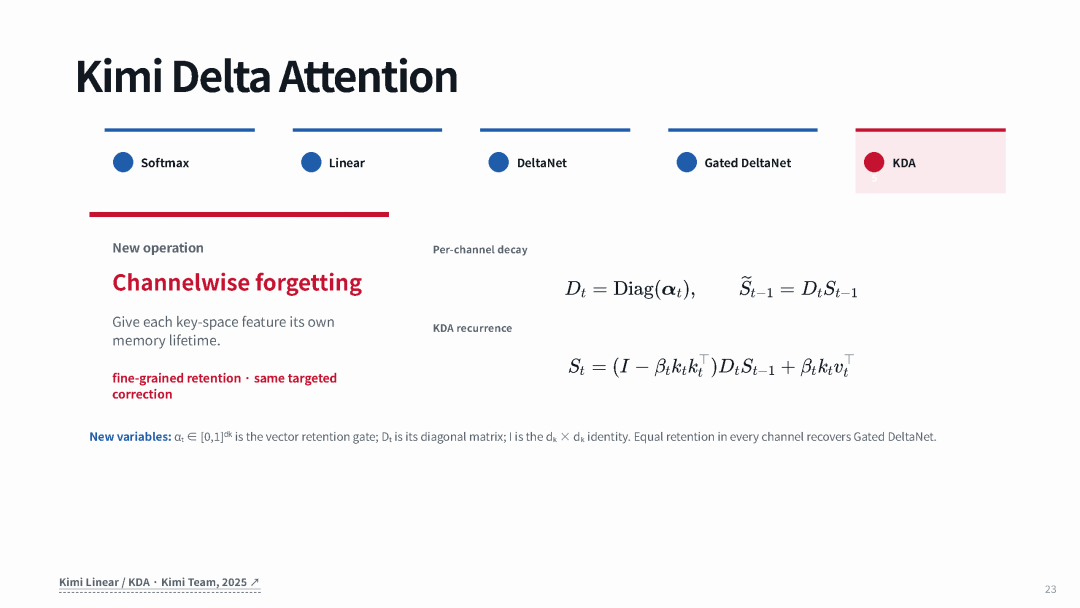
于是 “有些通道的上下文能存很长,有些只存很短”。Neubig 顺带一提:Mamba思路很像,只是数学更复杂,他这次跳过了。
3)稀疏注意力(Sparse attention)
不注意前文的全部,只注意其中一部分。有两种典型:
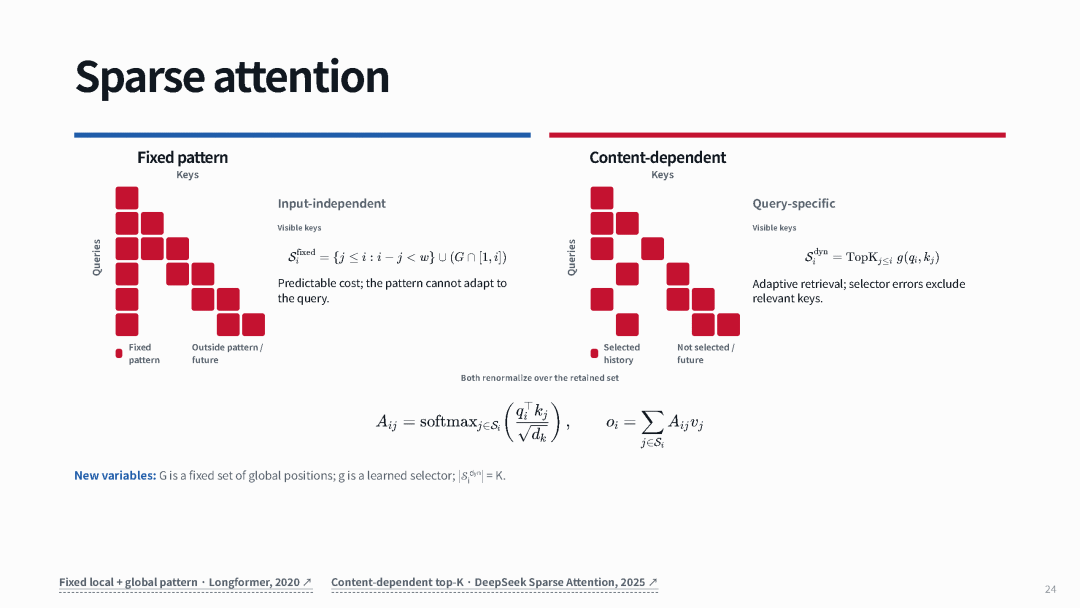
固定模式:比如每隔 512 token 做一次稀疏注意力。仍是二次方,但小了 512 倍,通常“够用了”。代价可预测,但不能随 query 自适应。
内容相关的 top-K:先用很便宜的方式算注意力(比如把注意力向量降到很小的维度),挑出 top-K,再对这 top-K 做完整注意力。DeepSeek 用的就是这种。有学生问“相似度怎么定义、是余弦距离吗”,Neubig 答“通常是点积,也可能事先归一化过,细节我不确定” —— 很实在。
4)KV 压缩(KV compression)
问题:KV cache 太大太贵,大到装不下一张 GPU。
两条主线:
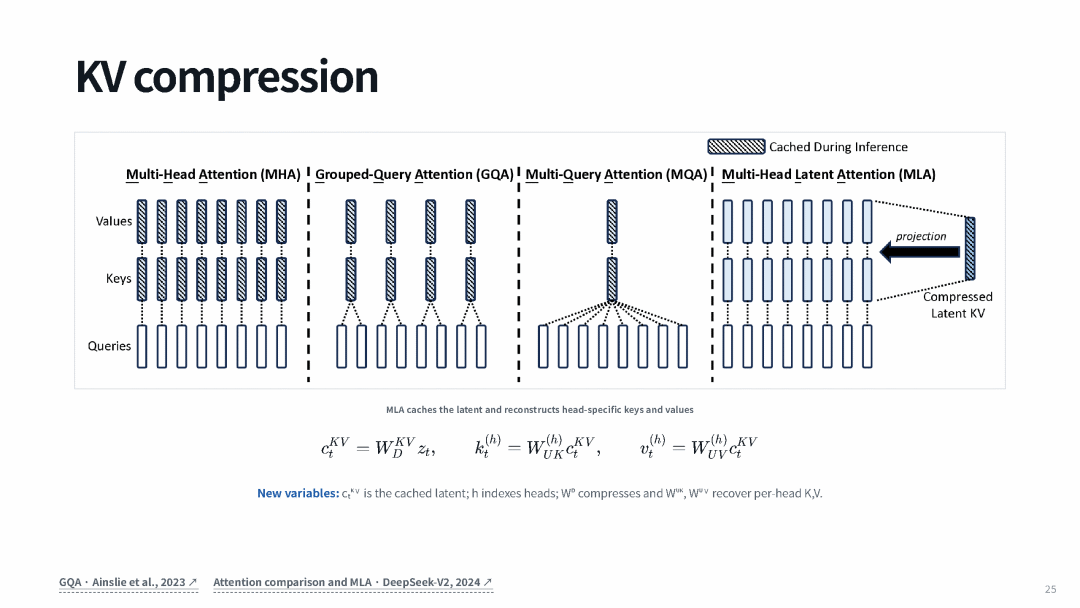
GQA(Grouped Query Attention,分组查询注意力):用比头数 h 更少(通常 h 除以某个 2 的幂)的 key/value。减少 KV 头数 = 减少 KV cache 显存,通常能省 4~8 倍。MQA(多查询)就是 GQA 取 1 的极端情况。
MLA(Multi-head Latent Attention,多头潜在注意力):不是减头数,而是把每个头做小 —— 缓存一个降维后的潜在向量,再重建出每个头的 K/V。两者还能叠加使用。
Neubig 小结这一段:靠这些架构方法,就能把长上下文撑到一百万 token 级别,让 “效率” 成为可能。
四、训练长上下文模型:难在哪、怎么练
架构能撑一百万 token,但把模型真正训练到会用一百万 token,其实相当难。难点很朴素:
互联网上根本没那么多 “连贯的 128K token 文本”。 128K 已经比大多数维基百科条目长,你开始需要 “一整本书” 级别的连贯文本,而网上没那么多书。
所以典型做法是 短→长 的三段式:
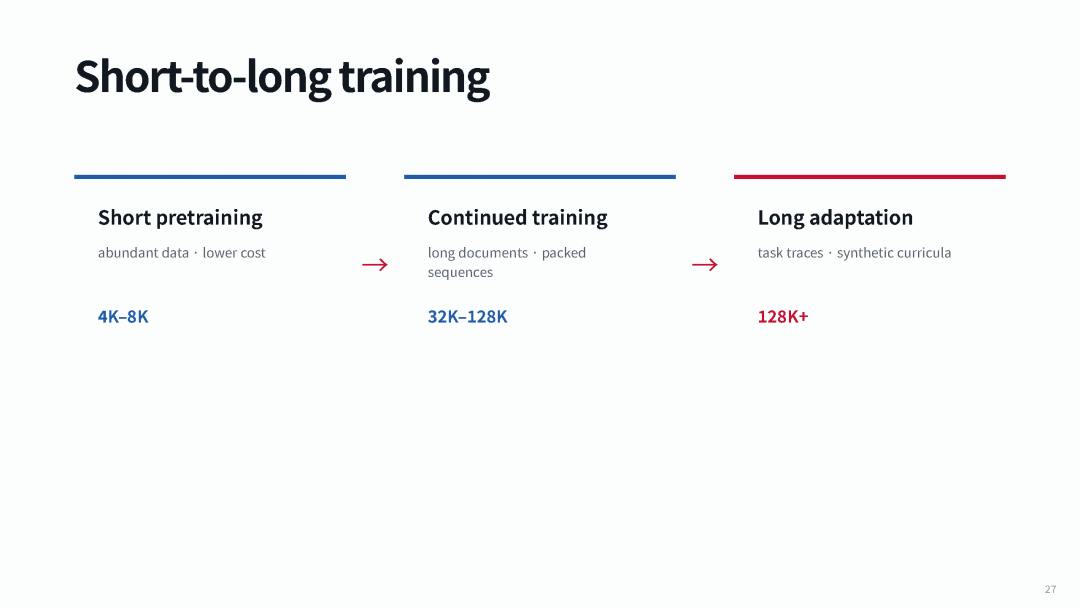
这里有个关键提醒:打包序列(packed sequences)对学 “长距离连贯” 没用。你把 10 篇文档拼进一个序列,模型并没有在学“跨文档注意”,而且它本来也不该跨 —— 所以真正要练长上下文,你需要连贯的长数据。
位置编码:绝对、RoPE、还是干脆不要?
绝对位置编码:每个词嵌入加一个位置向量(经典是 sin/cos 正弦编码)。位置在做 Q/K/V 投影之前就注入了。
RoPE(旋转位置编码):Neubig 说它 “数学上挺优雅”。它想解决的问题是 —— 让位置编码只由两个 token 的相对距离决定,而不希望绝对位置影响两个 token 是否互相注意。
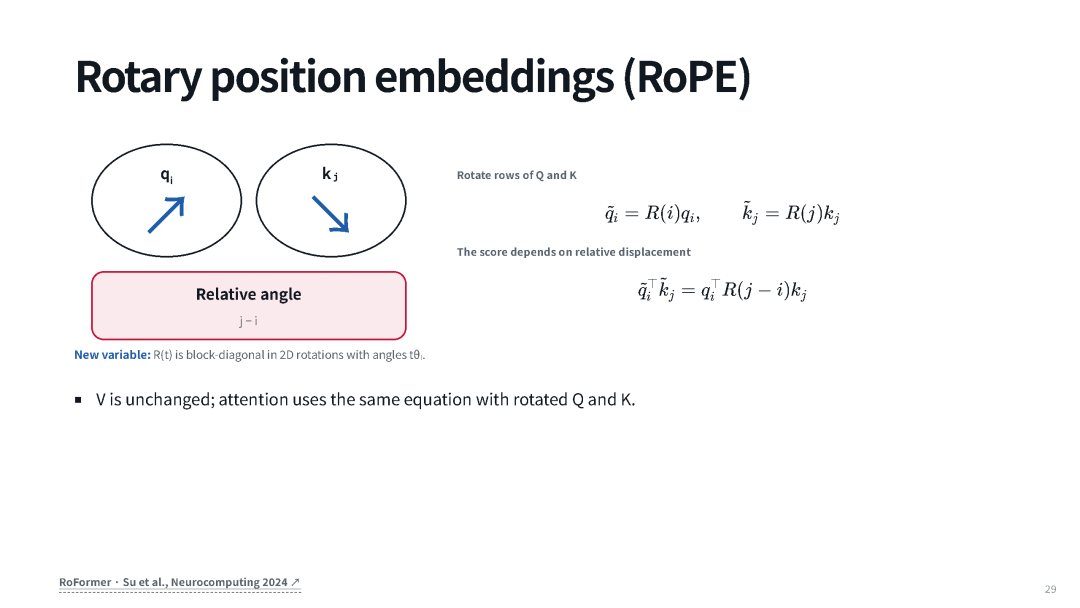
NoPE(不用位置编码):一个 “超反直觉” 的做法。你可能在 transformer 课上听过 —— “没有位置编码,位置 1 和位置 5 的表示就会完全一样”。Neubig 说:在当年的原始 transformer 上也许成立,但对我们现在用的自回归 transformer 不再成立了。
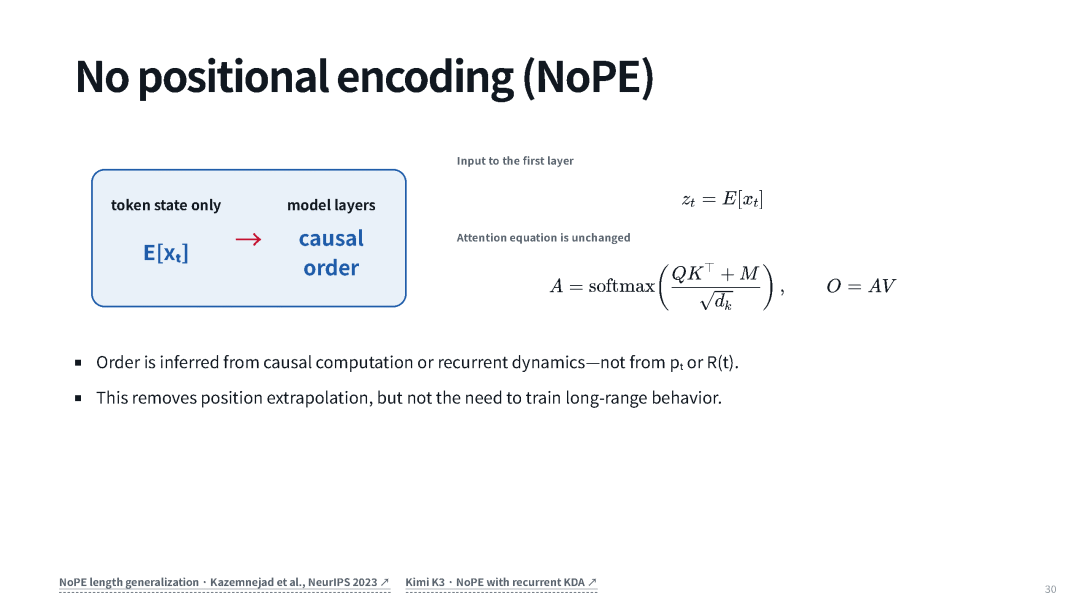
为什么行?因为因果掩码(causal masking)。学生答对了这一点,Neubig 展开解释:即便 “cat ”出现在位置 2 和位置 5,位置 2 的 cat 只能注意前 1 个 token、位置 5 的 cat 能注意前 4 个 —— 从第一层注意力起,它们的表示就已经不同了。而且像 Gated Delta 这种带衰减项的局部偏置,天然让每个 token 各不相同,就更不需要位置编码了。回看那张模型表:前两个用(部分)RoPE,后两个用 NoPE,Nemotron 靠 Mamba 的隐式顺序,Inkling 用相对位置编码 —— 业界基本对半分。
位置插值与 YaRN:把训练时的短窗口 “拉长”
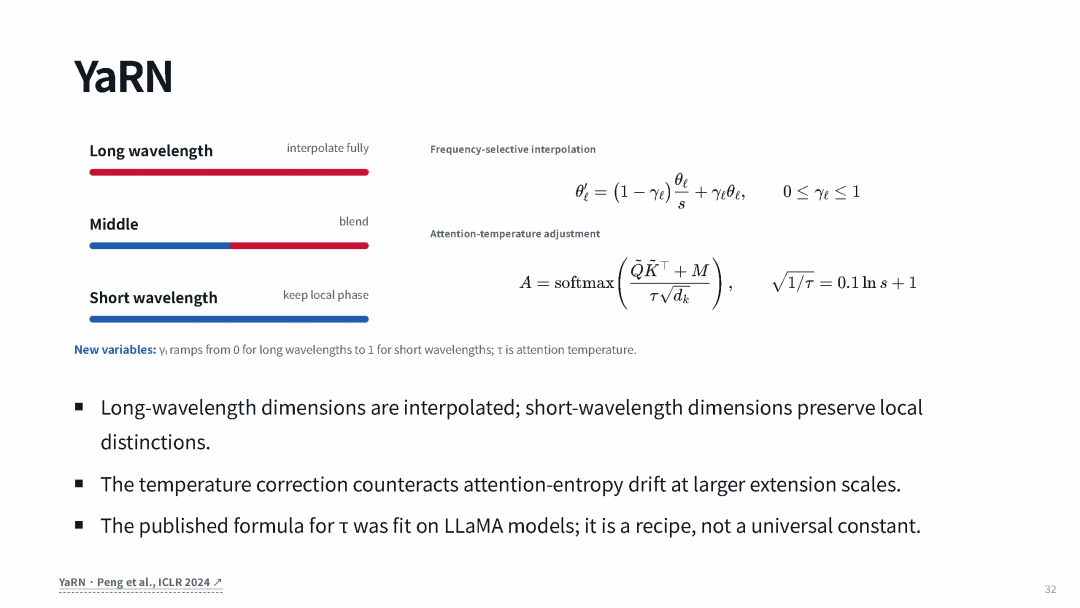
就算你用了 RoPE,长上下文还有个坑:如果你在长度 L 上训练,再想扩展到 sL,模型从没见过 “距离超过 L 的两个 token 互相注意”,自然处理不好。
修法是调 RoPE 里控制 “每步旋转多少”的 θ 参数,把它除以扩展倍数 —— 相当于把 RoPE 的位置 “拉伸”,让扩展后的长位置落回预训练见过的相位范围。
更精细的做法叫 YaRN —— 思路和 KDA 的 “逐通道” 异曲同工:不对所有维度用同一个频率去插值,而是让一部分维度拉伸得多、一部分拉伸得少(长波长维度充分插值,短波长维度保留局部区分度),再配一个注意力温度校正。
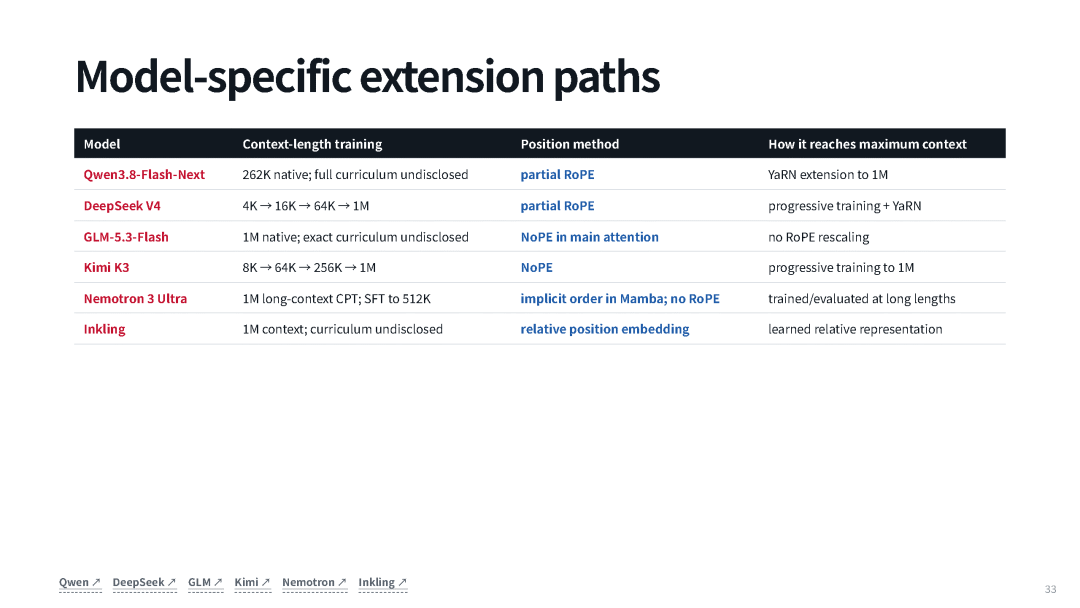
各家模型的具体扩展路径也在讲义里列了(Qwen 用 YaRN 扩到 1M、DeepSeek V4 走 4K→16K→64K→1M 的渐进训练 + YaRN、GLM 主注意力用 NoPE 不做 RoPE 缩放、Kimi K3 全程渐进训到 1M……):
长上下文数据:从哪儿来
打包只能教模型 “处理靠近窗口末尾的东西”,教不了全局连贯。真正有用的长数据来源:
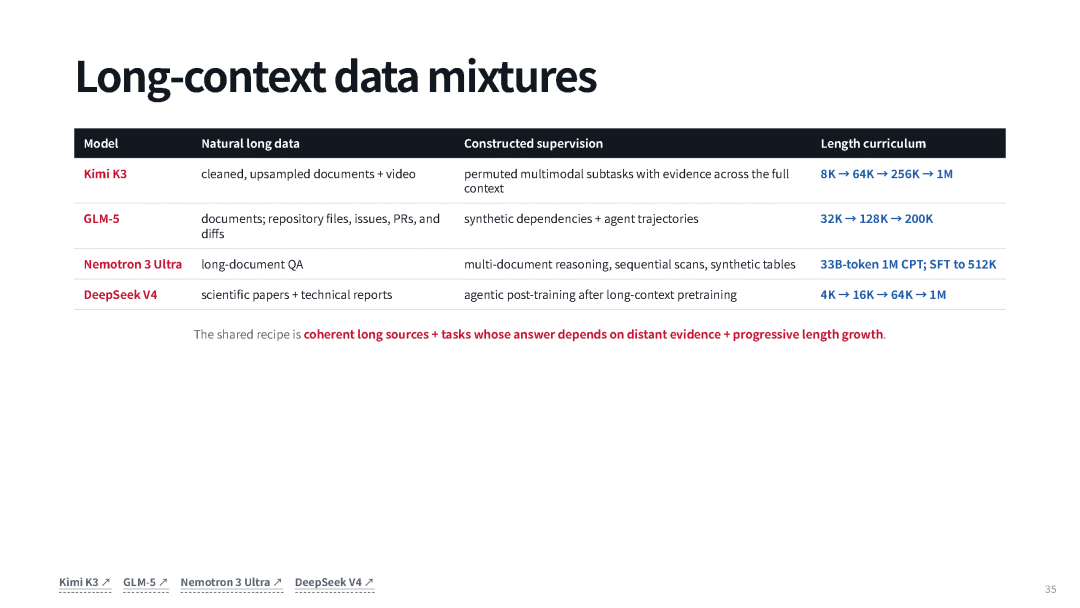
长文档:书、代码库(天然连贯)、同主题多文档语料,甚至专利(公开数据多、可互相链接)。
Agent 轨迹:如今的大来源—— “你只要跟 Agent 交互一会儿,轨迹就能拉得非常长”。
合成任务:大量评测本身就是合成任务,把证据和干扰项放在设计好的位置。
Neubig 顺带点破行业现状:闭源模型(Anthropic、OpenAI、Gemini)连架构细节都不放;开源模型必须放架构(否则没法跑),但它们把数据配方和训练策略藏着掖着。所以关于数据,业界能说的细节反而更少。共同的配方是:连贯的长来源 + 答案依赖远处证据的任务 + 渐进的长度增长。
一个工程坑:上下文并行(Context parallelism)
训练超长上下文时,除了数据并行、模型并行(专家/张量/流水线并行),还需要上下文并行 —— 把一段上下文的 K/V 在设备间接力计算传递。超过 32K 上下文就开始重要。
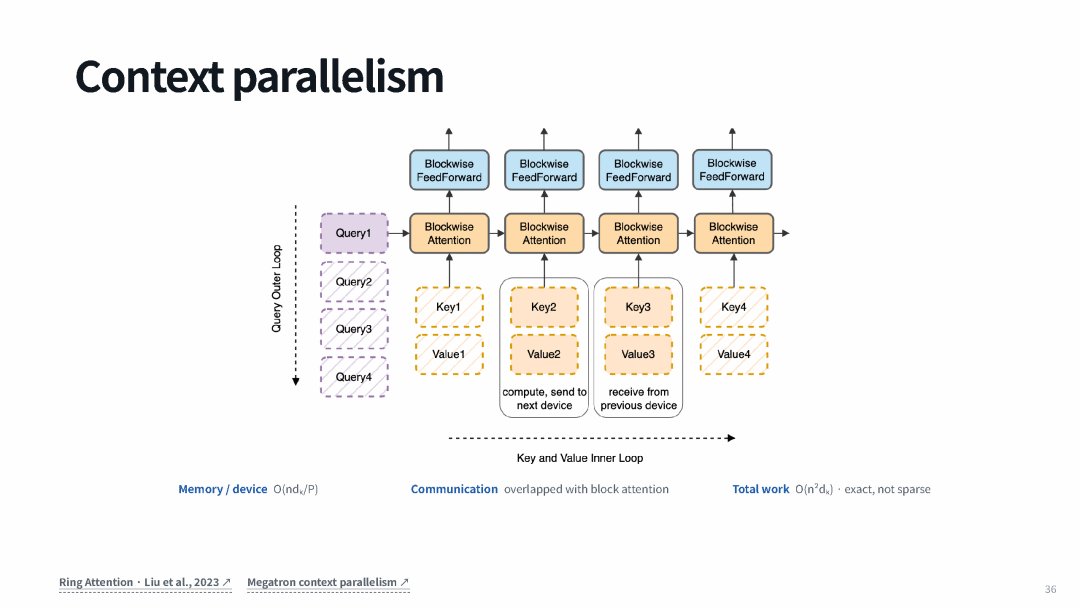
Neubig 讲了个亲历的坑:他想给一个较小的 Qwen 模型上下文并行训练,结果 “整个互联网上都找不到 Gated DeltaNet 的上下文并行 kernel” ,你要么自己写 kernel,要么换方案。标准注意力、滑动窗口这些有现成 kernel,越是非标准的注意力操作,工程越难 —— 建模团队和 infra 团队常常在这儿打架。
五、Prompt 与 KV 缓存:省钱关键,别不小心破坏它
这一块即使你不训模型、只是用 Agent,也必须懂。
回顾一下 KV 缓存在解码中的作用:每次生成 token 都要算 KV,但算完就可以扔进缓存下次复用;工具结果是新输入,需要重新 prefill,之后就并入那段可复用的前缀。
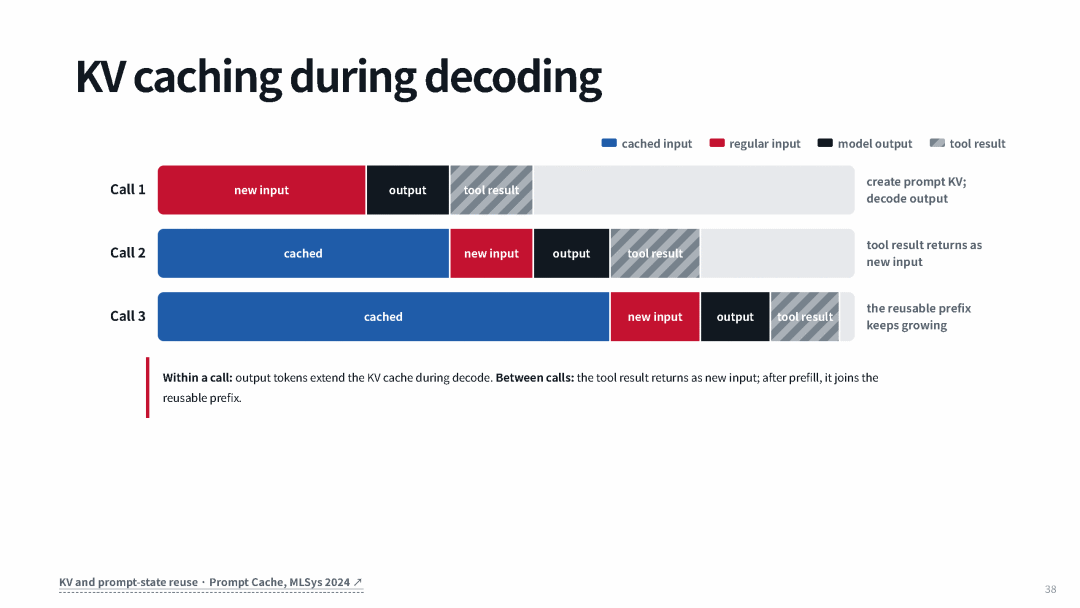
到第 50 步时,如果你没做任何取巧,历史会是新输入的 50 倍 —— 缓存得当,就是巨大的成本节省。
这直接体现在你为运行 Agent 付多少钱上。Neubig 从各家官方定价拉了一张表:
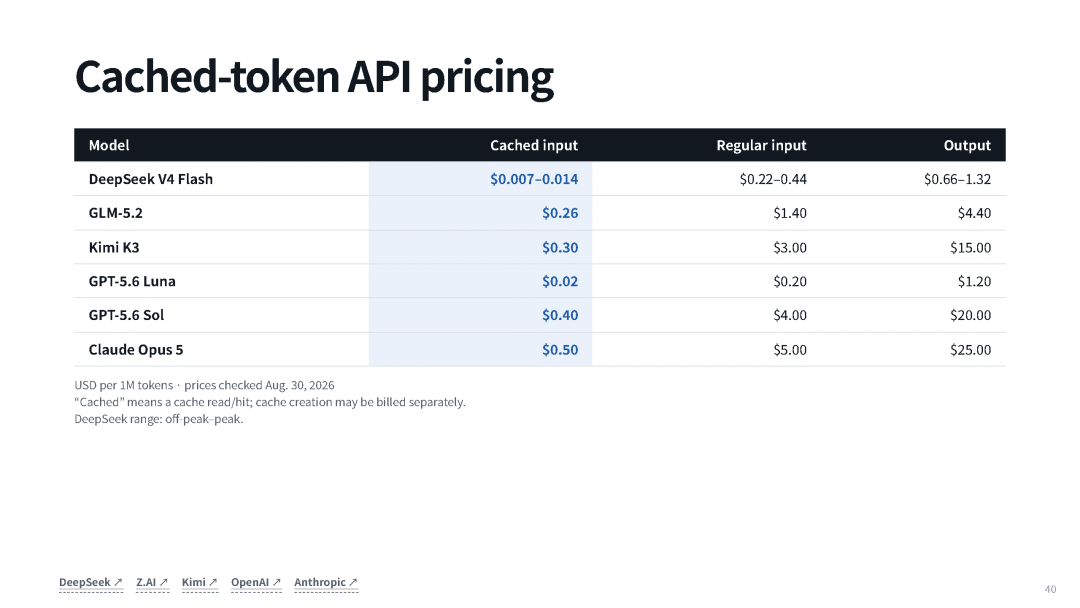
两条经验值得特别注意:
缓存 token 通常是未缓存的约 1/10 —— 所以你必须清楚自己的 token 到底有没有命中缓存,否则钱哗哗地烧。
输出 token 又往往是输入的约 5 倍,缓存输入和输出之间能差到 50 倍。
课堂互动里,Neubig 问 “跑 Agent 时多高的缓存命中率算好”,他给的标准是:90%~95% 我就满意了,低于这个你可能在某处漏钱。
那么系统层面怎么把缓存管好?两大开源服务库的看家创新:
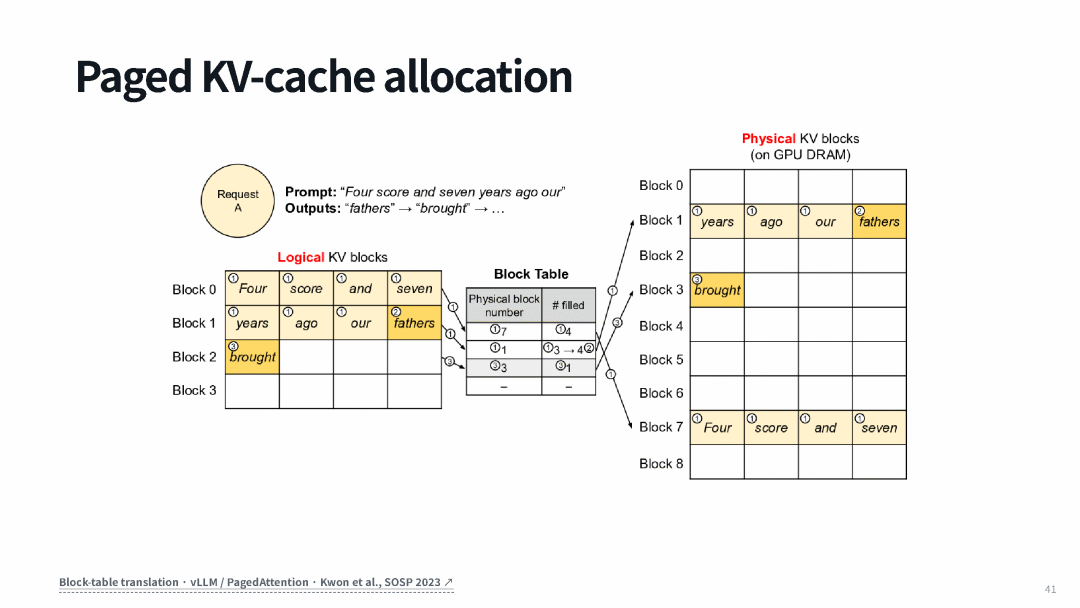
PagedAttention(vLLM 的核心创新):把 GPU 显存像操作系统的内存页/磁盘块一样管理——物理块可以乱序排列,用一张索引表(block table)映射。好处是能并行生成多条序列,生成完可以整块驱逐,让并行服务更高效。
RadixAttention(SGLang 的核心创新):专门用来复用已缓存的输入前缀 —— 用一棵基数树(radix tree)组织,快速查找 “已经用过的前缀”。
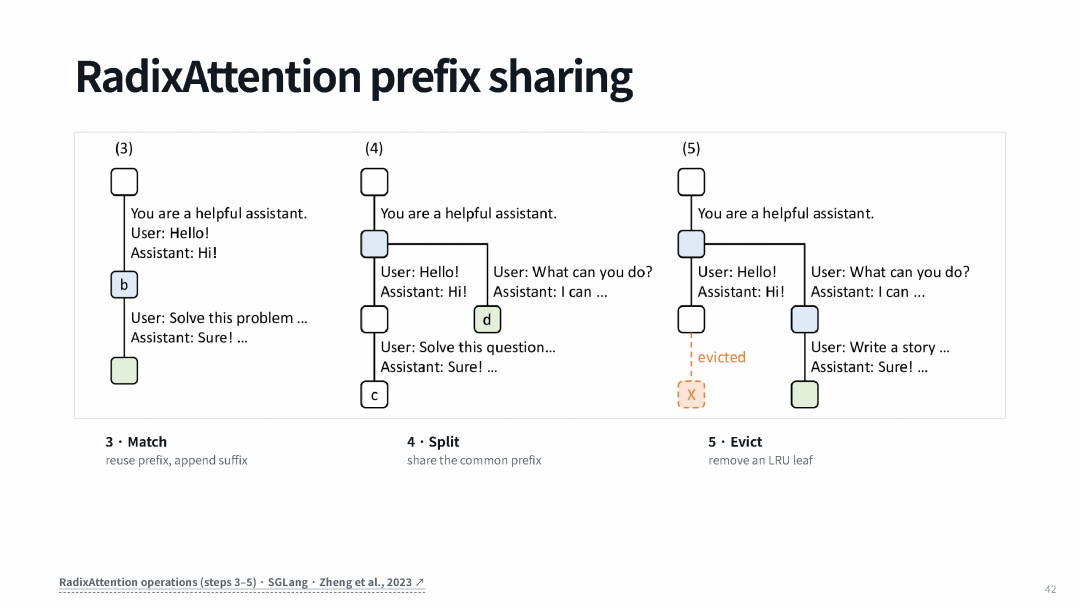
它最初是为聊天机器人设计的(对话可以续接、复用前面的缓存),但对 Agent 更重要,因为 Agent 对话又长又频繁,查找命中的收益更大。
缓存感知路由(Cache-aware routing):多机服务时,一个请求进来,你想把它路由到 “手里有最匹配 KV 缓存” 的那台机器。
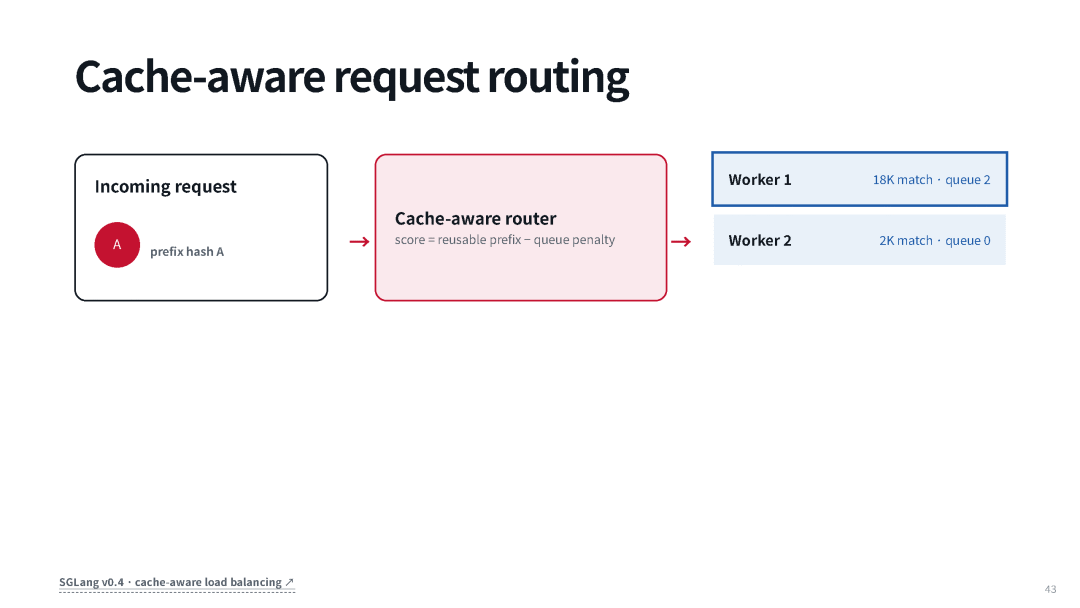
Neubig 补了两个影响缓存命中率的现实因素:缓存驱逐有多快(provider 不会永久替你保留缓存 —— Anthropic 早期是 5 分钟,现在可选到 1 小时但更贵),以及路由做得好不好。坏消息是:定价并不会因为 provider 缓存策略好坏而变 —— 它把你过早驱逐,你照样多付钱,有点不公平。
给写 harness 的人:别不小心破坏缓存
这是这一段最实用的落地箴言。缓存只在 “整段前缀完全一致” 时才有效,所以有些 “看起来很合理” 的操作是大忌:
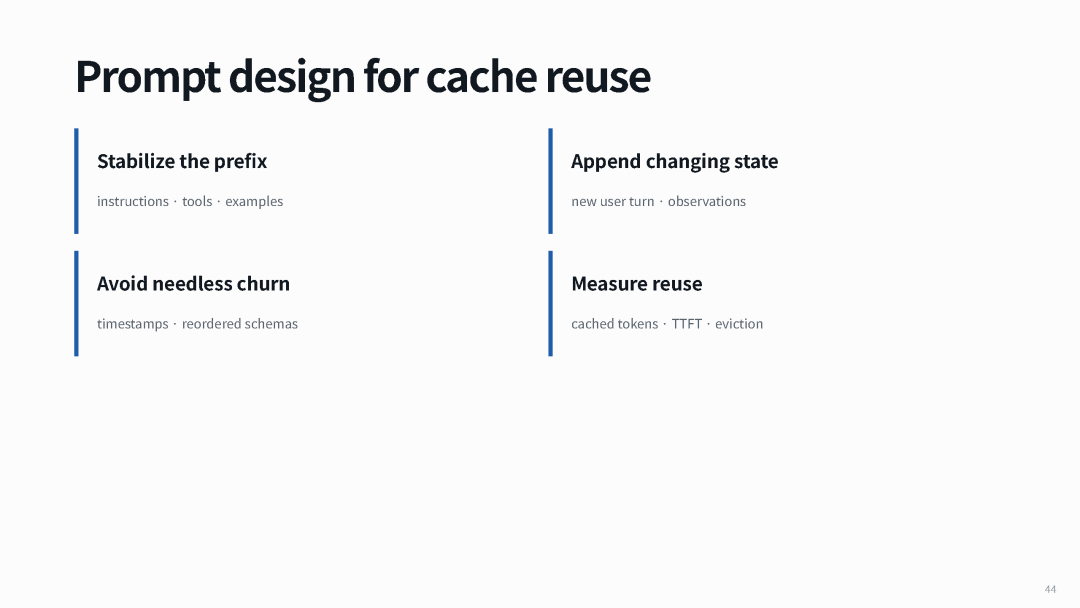
❌ 别每步都改系统消息 —— 那等于完全没法缓存。
❌ 别把当前时间/日期拼进系统消息 —— 它每步都变,直接破坏缓存。要加就加到最后一条用户消息或工具结果里。
✅ 中途动态增删工具是可以的。
⚠️ 每步切换到不同模型要非常克制 —— 即便你想 “这步用强模型、后几步用便宜模型省钱”,可你下次再切回强模型时,还是要重付它那 10 倍的缓存代价,频繁切换反而更贵。
一句话:稳定的东西放前面(指令、工具、示例),会变的东西追加到末尾。
六、上下文压缩(Compaction):撑不住时的最后一招
Neubig 问全场:“你们有多少人用编程 Agent 时看到 compacting context 会很兴奋?” —— 全场没人举手,哄堂大笑。
压缩的基本思想是:把之前一长串观察和动作,压缩成前文的精华。
大家不爱它的原因很直白:压得不好,Agent 就会忘事、跑偏,甚至给你删文件系统。
Neubig 把压缩形式化成一个状态估计问题:
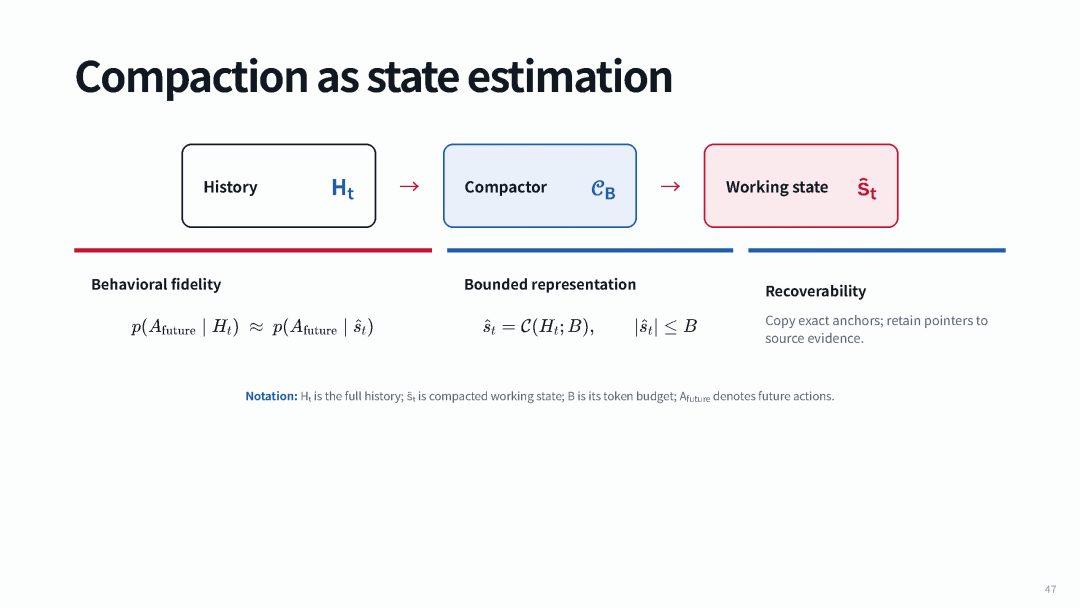
你把历史压成一个工作状态,目标是让压缩之后的 “未来动作序列” 和压缩之前一样好(甚至更好),同时状态还得足够小。
**那什么该在压缩里活下来?**常见策略是:保留三类 + 一个外部存储:
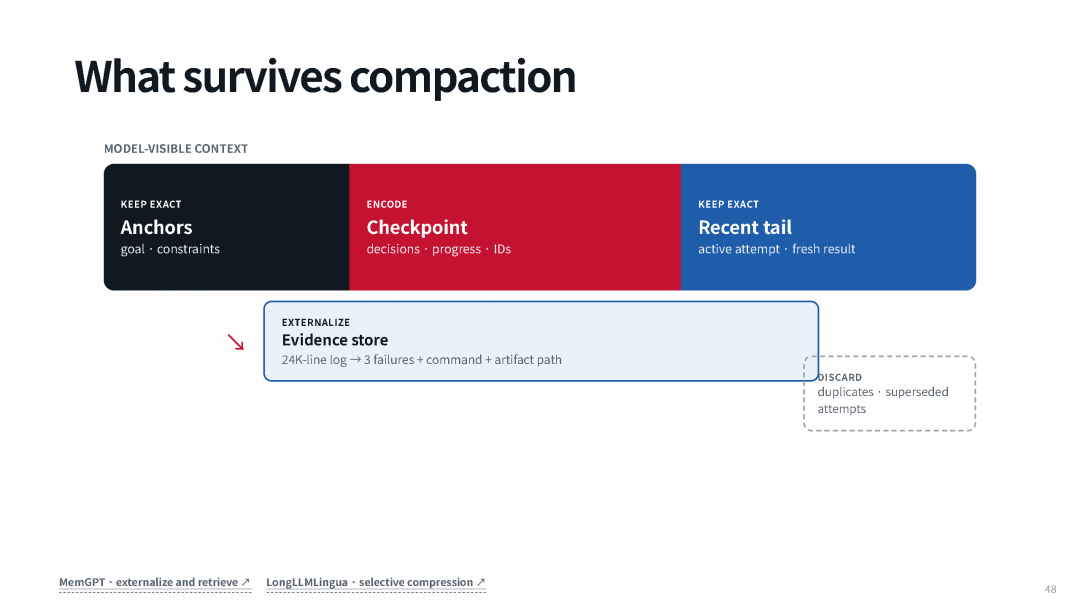
锚点(Anchors):比如会话最开头用户说的话。Neubig 说 “Agent 忘掉开头” 有时正是 harness 的设计 bug —— 好的 harness 会刻意避免删掉开头,因为它更重要。
检查点(Checkpoint):中间的决策、进度、ID,编码后放回。
近期尾部(Recent tail):最近的动作往往原样保留。
证据外部化:大块日志丢进证据库;而且 CLI 编程 Agent 通常把完整历史存在磁盘上 —— 即便压缩丢了东西,你也能让 Agent 回去读磁盘历史找回来。
压缩策略由几部分组成:触发(trigger)有三种 —— token 阈值(比如超过 200K 就压)、被 provider 强制、或手动 /compact;做法上,可以是自由文本摘要,也可以是结构化摘要(要求一次工具调用,规定 “这些字段必须出现在摘要里” )。
Neubig 还提了一个冷知识—— 某头部大模型会把上下文压成一段加密的、你读不到的东西,因为不想让你偷学它的压缩算法。
一个血泪教训:小心 “反复压缩” 的漂移
Neubig 讲了 OpenHands 早期的真实故事,我觉得极其值得记住:
风险一:反复压缩会累积漂移。第一次压得好好的,但一路压下去,你会丢得越来越多。
风险二:光靠 benchmark 会骗过你。他们当年做了个自认为很棒的压缩算法(叫 compression),在 SWE-bench 上 “完全不掉分、还省了很多 token”,兴冲冲上线,结果在真实系统里犯各种蠢:
它压缩后忘了自己已经发过 PR,于是同一个功能给你发了五个 pull request;还会忘掉对话中途用户下的指令 —— 因为我们只在 “单轮对话” 上评测过,把多轮的用户消息给压没了。
教训一针见血:除非你有极其鲁棒、覆盖每种用例的 benchmark,否则光跑基准不够,你必须在真实环境里实测。
结语:能力要用得动,工程要供得起
Neubig 用一句话收束整讲,我原样翻译他的 takeaway:
Agent 循环增长得非常快;因此我们有一大堆推理上的挑战。我们通过架构和缓存来应对效率问题,而当规模超出我们能处理的范围时,压缩就是我们兜底的手段。
把这一讲拎成一条线:
问题:历史线性增长 → 处理量二次方爆炸,而且长上下文里模型还会 “用不动”。
容量侧(用得动):靠架构(滑动窗口 / 线性注意力 DeltaNet→Gated DeltaNet→KDA / 稀疏 / KV 压缩)撑住长度,靠训练(短到长课程、RoPE/NoPE、位置插值与 YaRN、连贯长数据)真正学会用。
效率侧(供得起):靠 KV 缓存(PagedAttention、RadixAttention、缓存路由)把成本压到 1/10,前提是你别不小心破坏缓存。
兜底:靠压缩在撑不住时保住核心状态 —— 但要防 “反复压缩漂移”,且必须在真实环境实测。
这一讲和前两讲严丝合缝:第一讲说 “Agent = 模型 + Harness 的循环”,第二讲探讨了循环里最关键的那根管子——工具调用,而这一讲回答了当这个循环越跑越长,系统怎么才能不崩。
下一讲,会转向 Skills 与 Memory(技能与记忆)—— 也就是把上下文管理拉到 “你和 Agent 相处的整段时间” 这个更长的尺度上。(有学生问 “子 Agent 算不算一种管理上下文的方式”,Neubig 说算,但留到后面专门讲。)
如果你也想认真啃一啃 “Agent 到底是怎么造出来、又怎么被服务起来的”,这门课的全部材料都免费公开:
朋友们,我们下一讲再见!
本文首发于 Haowen.AI 微信公众号。如果这篇分享对你有启发,欢迎点赞、收藏、转发给同样在学习路上的朋友。
雁评
真实、有观点的好评或吐槽,欢迎分享你的使用体验。