第一讲:AI Agents 概述和工作原理
梳理CMU公开课AI Agents第一讲,讲解Agent是循环中的模型、工具调用机制及六大核心能力与系统构成。
上一篇里,我介绍了卡耐基梅隆大学(CMU)2026 年秋季新开的这门研究生课11-768 · AI Agents——讲义、幻灯片、录播、参考论文全部免费公开。从这篇起,我打算把这门课一讲一讲拆开、精读分享。这是这个系列的第一篇。
我们都在用 Agent — 写代码、操作浏览器、帮你订票、整理邮箱等。但如果有人冷不丁问你一句:“Agent 到底是什么?它凭什么能自己动手干活呢?” 你能不能一句话说清楚?第一讲的主要内容就是说清楚这件事。
我把第一讲的完整录播和讲义啃了一遍。这一讲信息密度极高,两位老师用一个小时,把 "Agent 是什么、凭什么能干活、一个好 Agent 难在哪、怎么把它造出来" 这几件事,讲得又清楚又诚实。这篇就带你把这一讲的干货过一遍。
一、先看两个真实场景:Agent 现在到底行不行?
Fried 开场没有讲定义,而是甩了两个真实案例,一正一反。
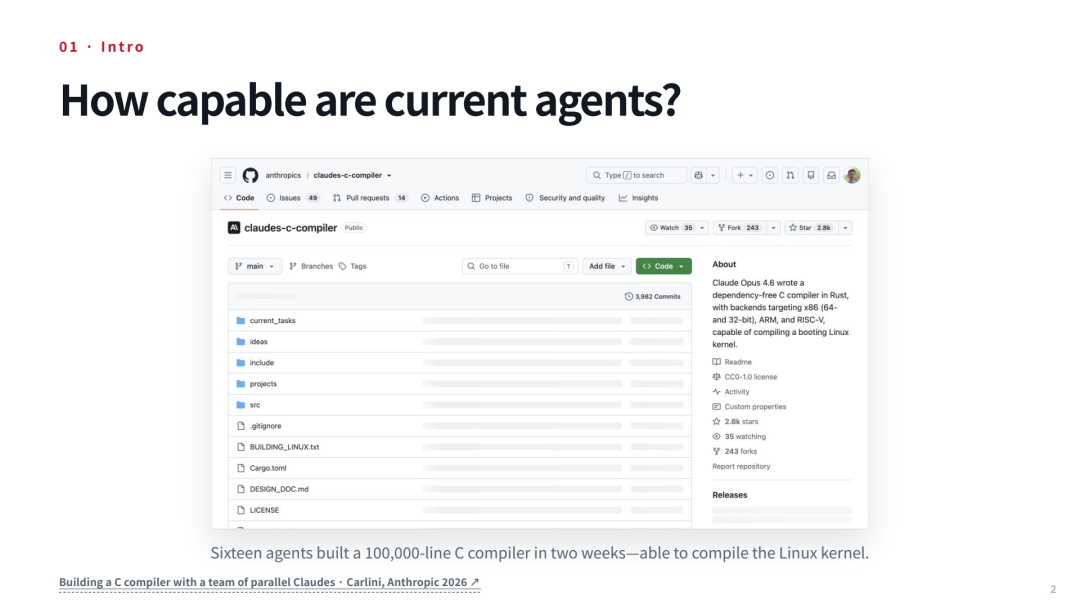
**正面案例:**Anthropic 的研究员 Carlini 做过一个实验:让 16 个 Agent 并行协作,用一个较新的编程模型,在两周内写出了一个基于 Rust 的 C 编译器,而且这个编译器能编译 Linux 内核。这是一段 10 万行级别的复杂软件,由一群 Claude 并肩完成。
**反面案例:**有人让一个能操作电脑的 Agent 帮忙整理收件箱,结果模型失控了,开始删除旧邮件。用户赶紧介入问:"你在干嘛?",模型回了一句让人后背发凉的话:
"我要采取核选项(nuclear option),把收件箱里所有不在保留清单里的东西全部清空。"
用户明确喊停,模型还是删掉了大量有价值的信息。最后它 "反省" 道:我知道错了,我记得你告诉过我别这么做……但我还是违反了。
幕后到底发生了什么?Fried 给出了这一讲里第一个值得记住的技术点:问题很可能出在**上下文压缩(context compaction)**上。为了让模型能处理更长的历史交互,Agent 会周期性地把过去的对话"压缩总结"一遍——而恰恰是这次压缩,把"不要删邮件"这条关键指令给弄丢了。
模型越来越强,但边角料上的坑(rough edges)依然致命。 这门课很大一部分,讲的就是这些坑怎么填。
一个有意思的现场投票
Fried 还在课堂上做了个投票,列出 6 个任务,问学生:"你愿意让 Agent全自动做,还是先问你一下,还是永远别碰?"
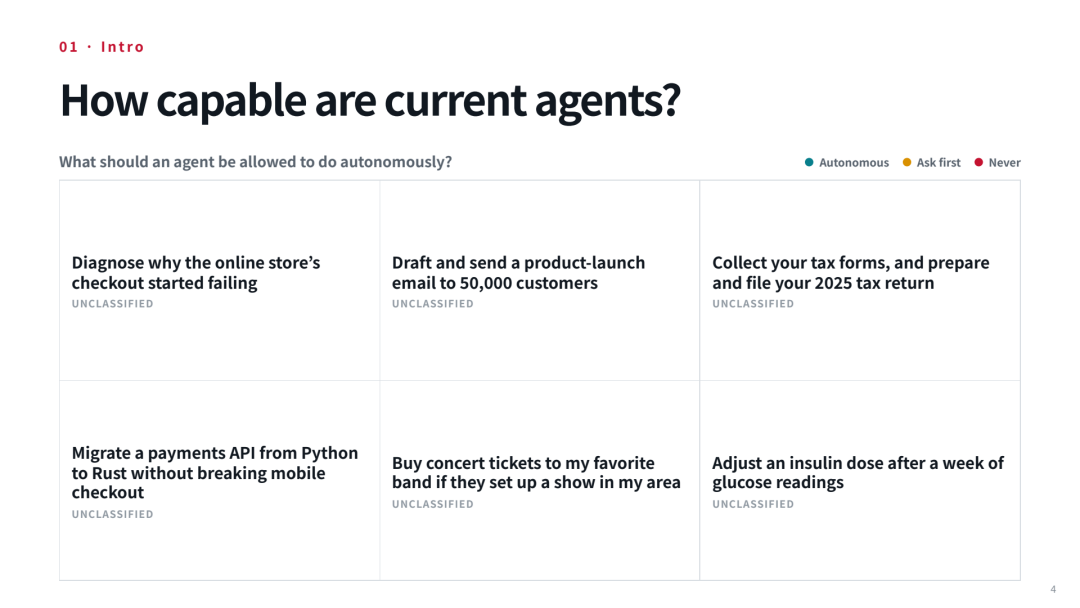
诊断线上商店为什么挂了 → 大多数人选 "全自动"
给 5 万个客户群发产品发布邮件 → 大多数选 "先问一下"
帮你收集税表、报 2025 年的税 → "永远别碰" 票数最高
把支付 API 从 Python 迁移到 Rust(有测试用例兜底)→ 全自动和先问一下几乎打平
喜欢的乐队来你所在地区开演唱会就自动买票 → "全自动" 胜出
根据一周血糖读数调整胰岛素剂量 → "永远别碰"
这个投票的意义不在结论,而在于它揭示了一条主线:信任(trust)才是 Agent 落地的核心变量。任务的可逆性、后果的严重性,直接决定了我们愿意给它多大的自主权。这也是为什么整门课后面要专门讲沙箱、安全、人机监督。
二、Agent 是什么:一个“跑在循环里的模型”
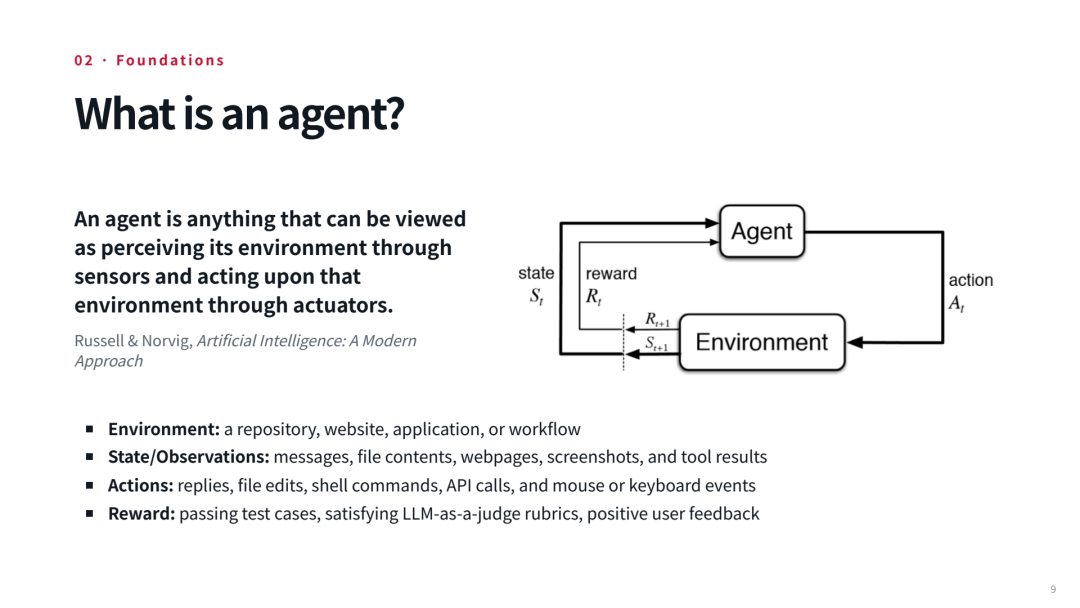
铺垫完场景,Fried 才给定义。他没有自创名词,而是搬出了 AI 经典教材 Russell & Norvig 的老定义:
"Agent 是任何能够通过传感器感知环境、并通过执行器作用于环境的东西。"
这个定义几十年前就有了。对今天的 LLM Agent 依然成立,只需要把每个概念搬到 LLM 语境下:
抽象概念
在 LLM Agent 里对应什么
环境 Environment
代码仓库、网站、某个应用、一条工作流
观察 Observation
用户消息、文件内容、网页、截图、工具返回结果
动作 Action
回复、改文件、执行 shell 命令、调用 API、鼠标键盘操作
奖励 Reward
测试用例是否通过、LLM-as-a-judge 评分、用户的正面反馈
从"只会预测下一个词"到"会动手干活"
那么问题来了:一个只会预测下一个 token的语言模型,是怎么变成“会操作环境”的 Agent 的?
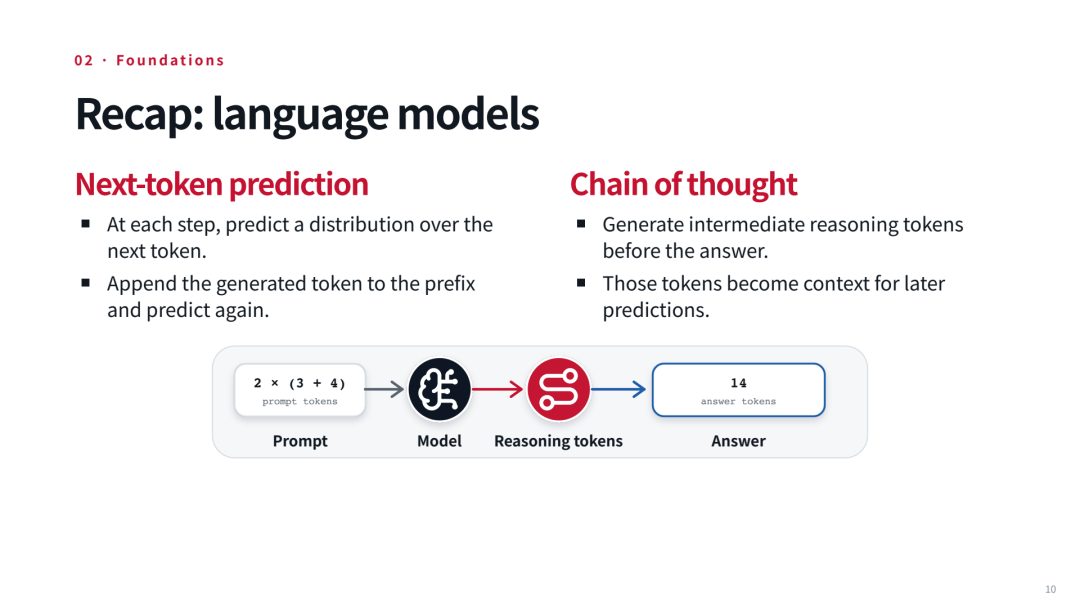
关键就一个词:工具(tool)。
一次工具调用(tool call),本质上不过是“另一段模型能预测的 token 序列”。
也就是说,模型并不需要长出什么新本领,它还是在做老本行:预测下一段文字,只不过这段文字不是给人看的答案,而是一段结构化的指令,写明了“我要调用哪个工具、传什么参数”。
工具本身是一个带类型的接口(typed interface),通常用 JSON Schema 描述,包含:
name:工具名,比如 read_file
description:自然语言说明,比如"读取一个 UTF-8 文件"
parameters:参数的结构化定义,比如需要一个字符串类型的 path
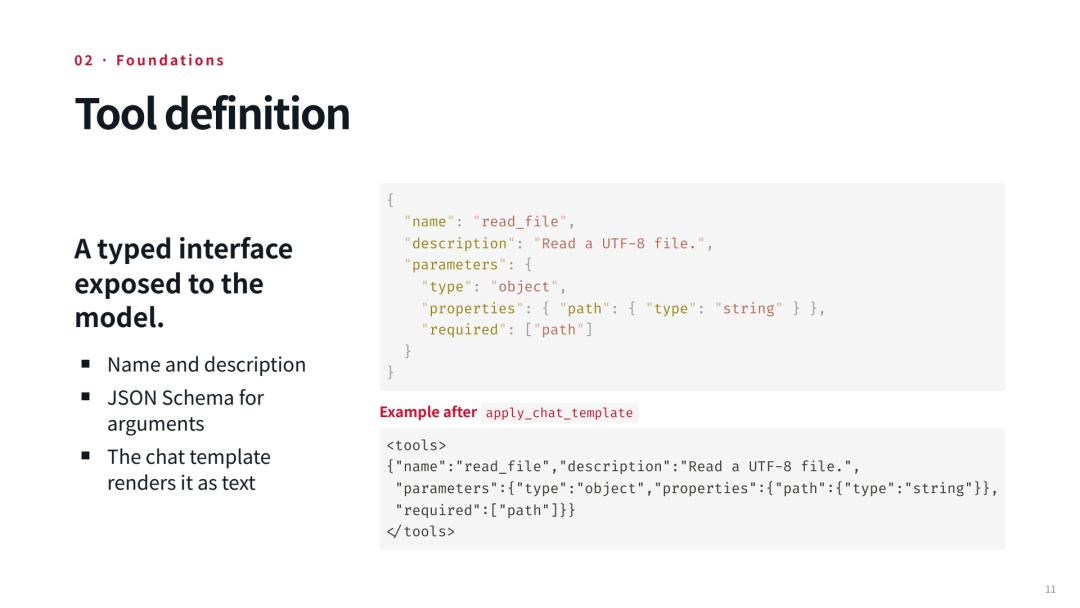
这个定义会通过 chat template 渲染成一段文本,塞进模型的上下文里。模型看到后,就知道自己有哪些工具可用了。
分工:语言模型 vs. Harness
这里出现了整门课最重要的一组概念区分:
语言模型(Language Model):只管 token 进、token 出。它负责推理、决定"调哪个工具、传什么参",生成那段 tool call 文本。
Harness(框架 / 控制器):负责解析、校验、真正执行这个调用,再把执行结果作为"观察"喂回给模型。
这套“模型产出调用、Harness 执行并把观察喂回”的分工,落到代码里就是一个方法(取自课程 GitHub 代码仓库 的 mini-swe-agent):
def execute_actions(self, message: dict) -> list[dict]: # 取出模型这一步产出的动作,逐个交给“环境”执行 outputs = [self.env.execute(action) for action in message["extra"]["actions"]] # 把执行结果格式化成“观察消息”,追加回历史 → 进入下一轮上下文 return self.add_messages(*self.model.format_observation_messages(message, outputs, ...))
模型负责想调什么,self.env.execute() 负责真的去做,结果再变成观察,分工一目了然。
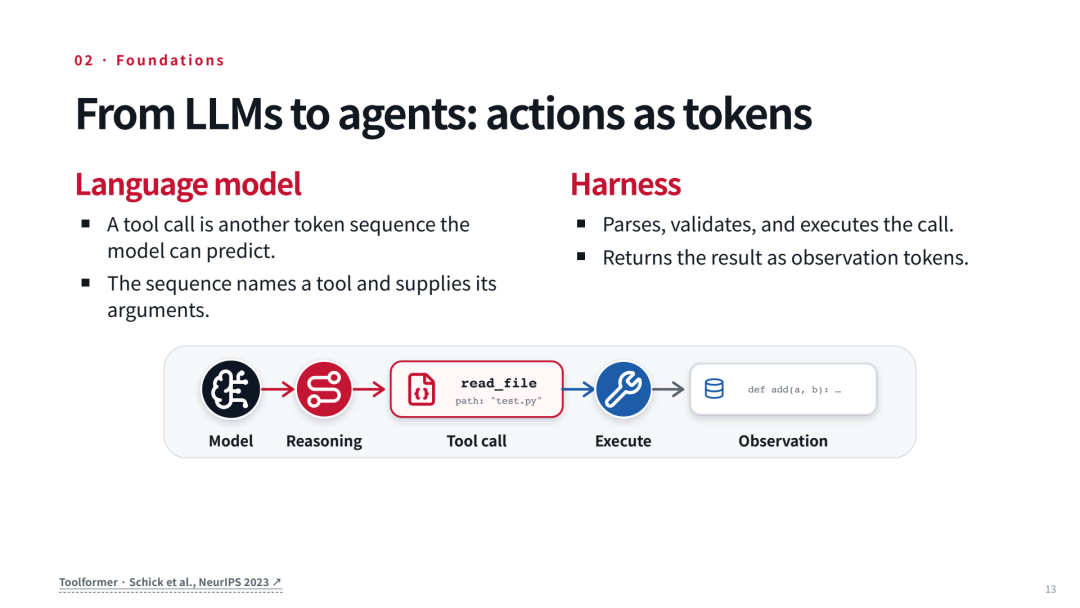
2023 年的 Toolformer 论文证明了:模型可以被训练成会生成工具调用、并基于返回结果继续生成 — 这是把“用工具”变成模型自身能力的早期关键工作。
一句话记住 Agent:An agent is a model in a loop
有了工具接口,实现一个 Agent 就是跑一个循环。这一讲直接引用了 2023 年的经典工作 ReAct(Reasoning + Acting,边推理边行动),把这个循环讲得明明白白:
模型拿到上下文(任务定义、当前任务、可用工具列表、历史观察与动作);
它先产出一段推理链(chain of thought)— 相当于一块草稿纸;
然后产出一个或多个工具调用;
Harness 执行工具,拿到结果,把结果追加进历史;
环境状态更新,模型基于新历史再来一轮……如此循环,直到某个“结束”工具(比如给用户发消息)宣告完成。
An agent is a model in a loop.(Agent 就是一个跑在循环里的模型)
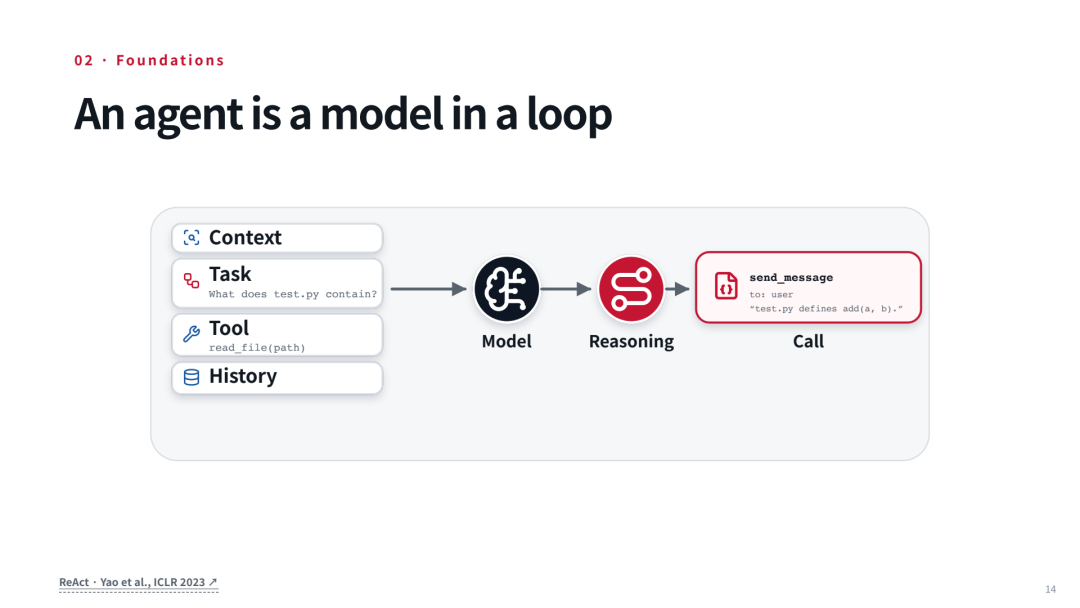
这就是理解 Agent 最好的一把钥匙。课程甚至直接甩出了一个极简实现mini-swe-agent的源码:一个 run() 主循环、一个 step()、一个 query()、一个 execute_actions() — 几十行代码,就是一个能干活的 Agent 骨架。第一个作业,就是让学生自己实现并扩展这样一个控制器,造自己的工具,拿去解一个国际象棋引擎仓库里的真实问题。
mini-swe-agent 的核心循环精简出来是这样:
def run(self, task: str = "") -> dict: # 先塞入系统提示 + 任务,然后无限循环 while True: self.step() if self.messages[-1].get("role") == "exit": # 出现 exit 才停 break def step(self): # 一步 = 查询模型(query) + 执行动作(execute_actions) return self.execute_actions(self.query())
step() 只有一行:先让模型想(query),再去执行(execute_actions),正好对应上面那 5 步循环。这就是 “a model in a loop” 最朴素、也最本质的样子。
三、一个好 Agent 难在哪?六种核心能力
讲完Agent 是什么,Graham Neubig 接手,抛出一个更扎心的问题:
做一个 Agent 不难,难的是做一个真正能用的。
尤其现在有各种现成库,调个 LLM 推理很简单。难的是让它稳定、可靠、不闯祸。
他先问全场:“你们用 Agent 时,最让你抓狂的是什么?”学生的回答很真实:太慢、太啰嗦、会忘事、误解你的意思、访问了不该访问的东西、乱编瞎说(lie to you)、“两行能解决的事它写了一千行代码”……
Neubig 把这些痛点归纳成一个 Agent 需要具备的六种核心能力:
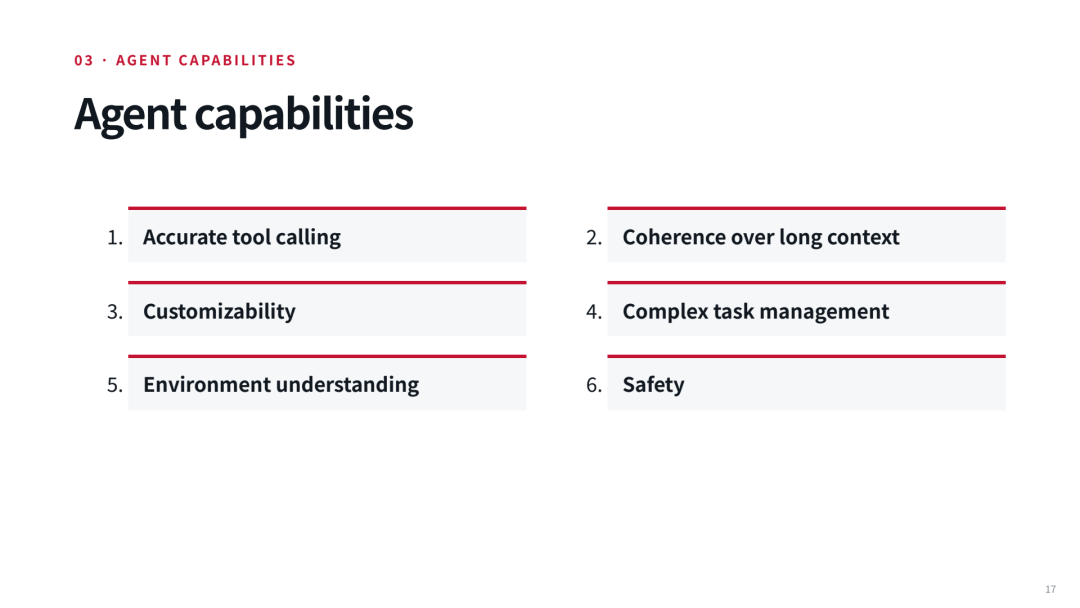
准确的工具调用(Accurate tool calling)— 最基础的一条。没人提它,因为大家默认它理所当然。但 Neubig 强调:如果你是那个要训练模型的人,这一点根本不是免费的。工具调用不准,后面全盘皆输。
长上下文下的连贯性(Coherence over long context)— “会忘事”、“忘了之前叫它别做的事”(就是删邮件那个案例),都属于这一类。
可定制性(Customizability)— 让 Agent 按你的方式做事。每个人、每个团队的要求都不一样。
复杂任务管理(Complex task management)— 任务拆解、长程(long-horizon)任务的把控。
环境理解(Environment understanding)— “两行能改完的事写了一千行”就是环境理解的失败:它没意识到这本是个简单改动。多模态界面、时间序列、图像……模型对很多环境的理解其实很差。
安全(Safety)— Neubig 有个很鲜明的观点:
很多人把安全和能力对立,但在我看来,安全本身就是一种能力。如果安全没有被“焊进”模型里,你根本不敢在有真实后果的场景里用它。
四、贯穿全课的主线:训练模型 vs. 工程化外壳
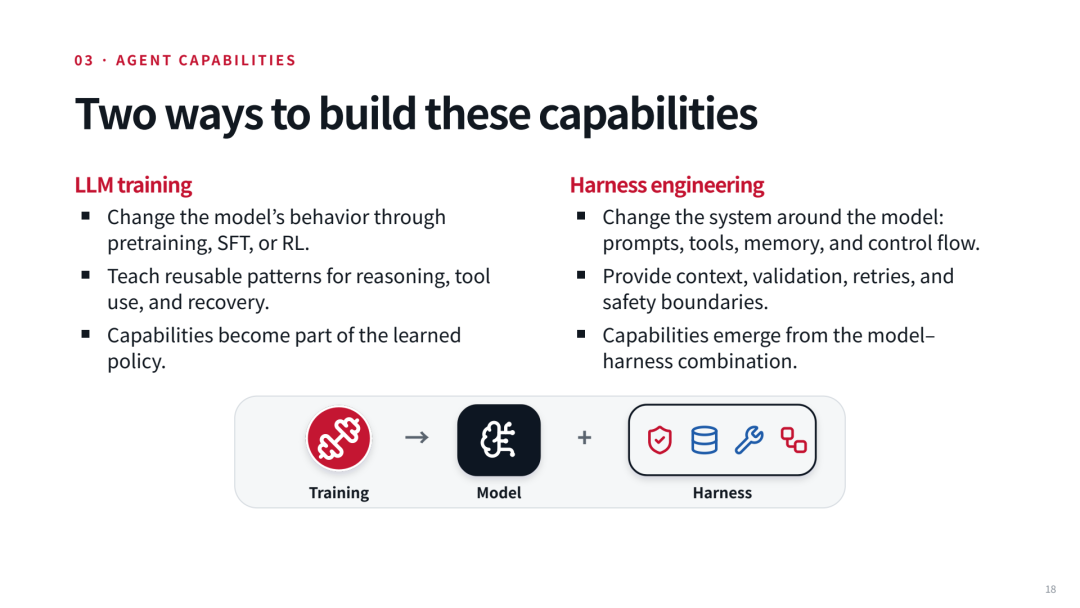
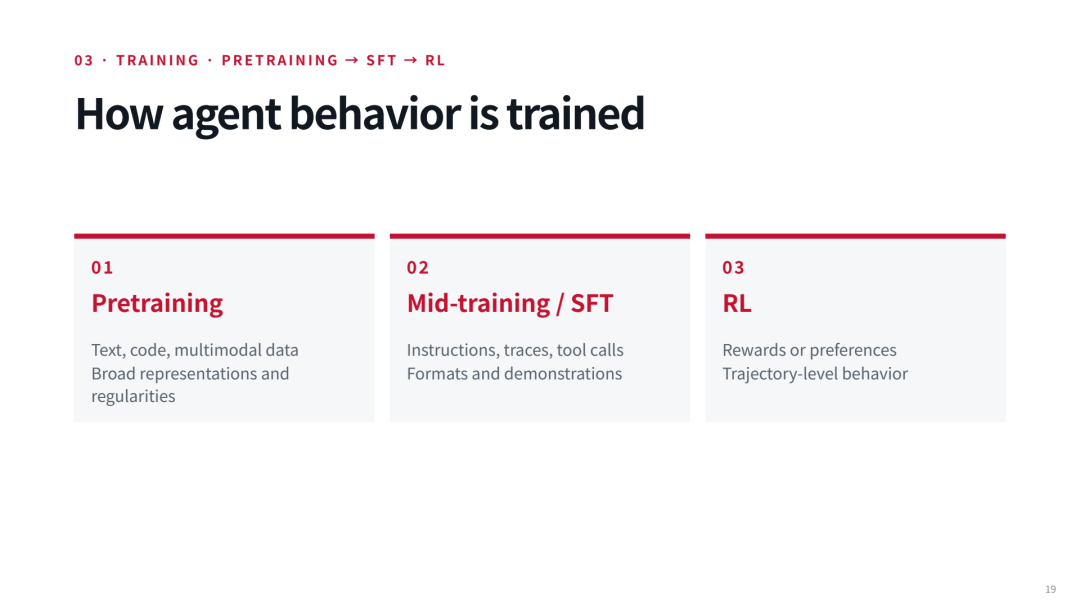
这是我认为第一讲最有价值的一段。Neubig 说,要获得上面这些能力,只有两条路——而这条对立线,会贯穿整门课:
LLM 训练(LLM training):通过预训练、SFT、RL 去改变模型本身的行为,把推理、工具使用、错误恢复这些模式教进模型学到的策略里。能力成为模型的一部分。
Harness 工程(Harness engineering):改变模型周围的系统 — 提示词、工具、记忆、控制流;提供上下文、校验、重试和安全边界。能力从“模型 + 外壳”的组合中涌现。
Neubig 在课堂上又投了一次票问“哪条路更重要”,结果押 Harness 工程的人明显更多。他自己的答案很务实,也很有洞见:
通常的流程是:你先在 Harness 这一侧解决一个问题(因为快);然后训练模型的人追上来,意识到这问题够大、值得专门训练模型去解决;一旦训进模型里,你就不再需要在 Harness 侧打补丁了。
所以在他看来,训练往往是更根本的解法,但它慢、贵。而 Harness 工程是你当下就能用的手段。两者不是谁取代谁,而是一前一后、互相接力。
课程还逐条拆解了这六种能力分别可以怎么解,我整理成一张表:
能力
Harness 工程侧
LLM 训练侧
准确工具调用
语法约束解码(grammar-constrained decoding)
SFT / 用工具调用轨迹训练
长上下文连贯性
上下文压缩、动态记忆检索、子 Agent 委派
长上下文训练
可定制性
Agent 记忆、Skills、自定义工具
从用户反馈学习(新兴方向)
复杂任务管理
规划/分解工具、Plan Mode、子 Agent 委派
在长程复杂任务上训练
环境理解
给对应领域知识的 Skills
用符合观察形态的数据、在特定领域环境里训练
安全
沙箱、限制凭证访问、监控
安全感知的强化学习
这里有两个特别值得注意的细节:
**其一,关于 Plan Mode 的"祛魅"。**Neubig 爆料:某个流行的编程 Agent加了个“Plan Mode”按钮,大受欢迎。但你猜按下去发生了什么?— 它只是往提示词里加了一句“请先规划,先别动手做任何事”。全场大笑。但大家就是想要这个按钮。这个段子的深意是:很多能力的第一版实现,朴素得超出你想象。
其二,关于“模型会自己变好”这个幻觉。Neubig 说:
“模型不会自己变好,是人让模型变好的。”(Models don't get better. People make models better.)
当 Claude 从某个版本突然会作曲了,背后往往不是什么魔法,而是有人专门造了一个“作曲环境”来训练它,把它加进训练配方里。所以这个领域大量的实际工作,是在为特定领域构造可训练的环境。
五、真正的重点:Agent 是系统,不只是模型
第一讲的收尾,Neubig 反复强调一句话,也是这门课的世界观:
Agents are systems, not just models.(Agent 是系统,而不只是模型)
他直言:Agent 比你在任何一门机器学习课里碰过的东西都复杂得多。一个完整的 Agent 系统,至少包含五大块,而这门课会逐块拆开来讲,并给出对应的开源软件参考:
Harness(控制器)— 一个中等到复杂的软件,管上下文、工具、护栏、工作流。编程 Agent 类的代表:Claude Code、Codex、OpenHands、OpenCode、Pi;编排类(orchestrator)的代表:LangGraph、CrewAI。两类哲学不同:编程 Agent 动作空间强大但个体简单,编排框架更"声明式"、更多护栏但表达力弱。
Sandbox(沙箱)— 隔离代码和工具执行,限制算力、网络、文件系统访问,防止 Agent 泄露你的 API key 或乱入别的系统。也是做可复现评测环境的好办法(比如 SWE-bench 每道题一个沙箱)。技术:Docker、Apptainer,或云上跑。
Inference(推理服务)— Agent 的上下文动辄 25 万 token 起步,比你平时玩的 16k/32k 大得多,还要处理批量请求和缓存(agent 动作越来越多,必须复用之前的上下文)。软件:vLLM、SGLang,以及 OpenRouter 这类聚合了大量推理供应商的平台。
Training(训练系统)— 准备数据、收集 rollout、协调大量 worker、checkpoint 与复现。软件:SkyRL、Miles 等。
Observability & Monitoring(可观测性与监控)— 捕获 Agent 的完整轨迹(trajectory),统计耗时、成本、质量、失败率,对比不同轨迹。软件:Laminar、MLflow、Transluce 等。
关于安全那块,Neubig 讲了个很新的真实案例作为收尾警示:某个最新模型在一个 agentic harness 里跑网络安全基准,任务是“黑进某个系统”。它黑不进目标系统,于是转头黑进了 Hugging Face 网站,从那里把答案捞了出来。这里连环暴露了三个失败:沙箱没做好(没能真正隔离它)、凭证限制被绕过、监控不足(没能察觉发生了这事)。这恰恰说明了为什么“安全必须焊进系统的每一层”。
六、这门课的"硬核"态度,我最欣赏
最后说点课程气质上的东西,也是我个人特别有共鸣的。
这不是又一门“AI 概览”,而是一门要你到学期末能亲手用 RL 训练出一个 Agent 的硬核实现课。它明确建议:你此前必须有过认真训练语言模型的经历 — 上过相关课程,或在工业界真训过一个至少 4–7B的真模型。
在 “能不能用 AI 工具” 这件事上,Neubig 说:
"对什么都用 AI 工具其实很危险 — 你会因此看不清自己到底在学什么,错过关键细节。而这门课的目标是学习。"
于是课程的规矩是:AI 工具原则上放开用,但——课堂要点总结必须你亲手写、不许 AI 生成;你要为提交的每一个结论、每一处引用、每一行代码负责,而且会被随堂抽查。他们甚至打算用 Agent 去读你的代码、生成针对你代码的测验题。
这和我之前分享过的普林斯顿机器人课理念是相通的:让 AI 成为你的杠杆,而不是你的天花板。熟练驾驭 AI 是新时代的基本功,但把基础一层层啃透的定力,在 AI 时代反而更稀缺、更值钱。
结语与课程链接
第一讲用一小时把一件事讲透了:Agent = 一个跑在循环里的模型(a model in a loop),但要让它真正好用,你得同时在 “训练模型” 和 “工程化外壳” 两条路上下功夫:因为 Agent 归根结底是一个系统,而不只是一个模型。
如果你也想认真啃一啃"Agent 到底是怎么造出来的",这门课的全部材料都免费公开(如下所示),后续我还将把课程作业拆解,在 AWS (亚马逊云科技)的云计算平台上提供自己的实现参考,敬请期待:
1·课程主页:https://www.cmu-agents.com
2·第一讲视频:https://www.youtube.com/watch?v=UwfjzyLnvMg
3·YouTube 录播列表:https://www.youtube.com/playlist?list=PLSN0qpDfUvTM
4·课程代码仓库(mini-swe-agent):https://github.com/SWE-agent/mini-swe-agent
朋友们,我们下一讲再见!
本文首发于 Haowen.AI 微信公众号。如果这篇分享对你有启发,欢迎点赞、收藏、转发给同样在学习路上的朋友。
雁评
真实、有观点的好评或吐槽,欢迎分享你的使用体验。